数据结构基础:队列的原理与C++实现
队列(Queue)是一种基础的线性数据结构,它严格遵循"先进先出"(First In First Out, FIFO)的原则。这意味着最先进入队列的元素,也必然是最先离开队列的。
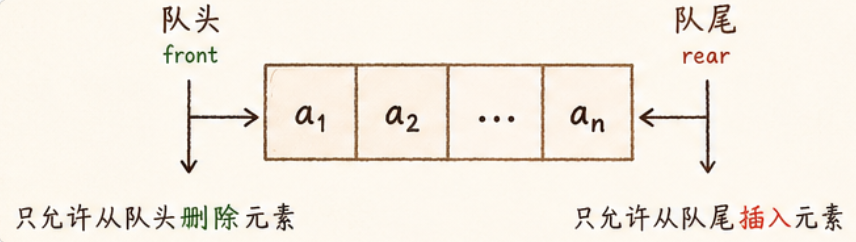
- 队首 (Front):允许删除操作的一端,也称为队头。
- 队尾 (Rear):允许插入操作的一端,也称为队尾。
- 入队 (Enqueue):将新元素添加到队尾的操作。
- 出队 (Dequeue):从队首移除元素的操作。
核心操作
队列提供了一系列基本操作来管理其元素:
| 方法 | 功能描述 |
|---|---|
bool enqueue(T element) |
将元素添加到队列尾部。 |
T dequeue() |
从队列头部移除并返回元素。 |
T front() |
获取队首元素,但不将其移除。 |
int size() |
获取队列中当前元素的数量。 |
bool isEmpty() |
检查队列是否为空。 |
队列的实现方式
1. 链式结构实现
链式结构常用于实现动态大小的队列,无需预先确定容量。
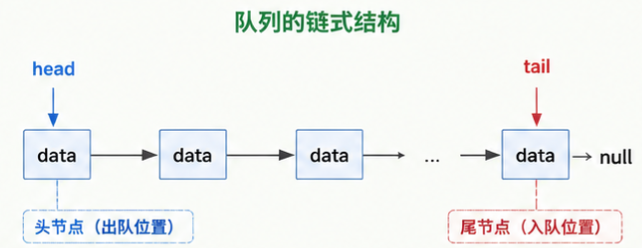
单向链表实现
使用单向链表实现队列时,关键在于维护队首和队尾两个指针。为了实现高效的入队和出队操作(O(1) 时间复杂度),我们通常采用"尾部插入,头部删除"的策略。
- 维护一个指向队尾节点的指针。
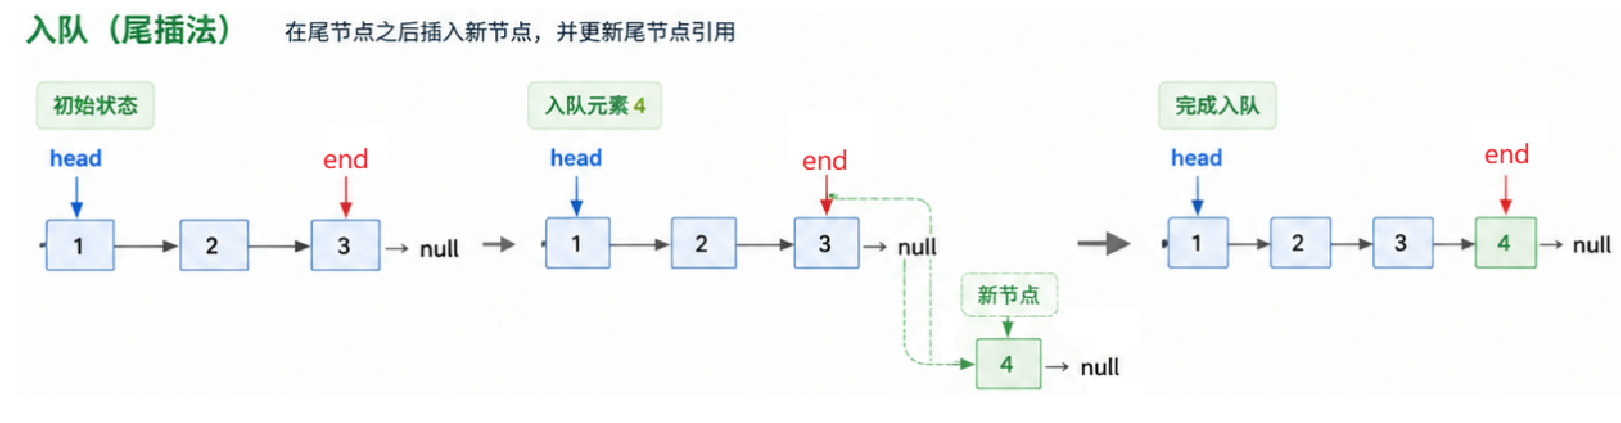
- 入队操作:在链表尾部插入新节点。
- 出队操作:删除链表头部节点。
入队过程图示:
出队过程图示:
需要注意的是,如果尝试从头部入队、从尾部出队,则在删除尾部节点时,单向链表需要遍历整个链表来找到尾部的前一个节点,这会导致出队操作的复杂度变为 O(N)。因此,"尾部插入,头部删除"是单向链表实现队列最有效的方式。
双向链表实现
双向链表由于每个节点都包含指向前一个和后一个节点的指针,在操作灵活性上优于单向链表。它可以很方便地实现"尾部插入,头部删除"或"头部插入,尾部删除"两种模式,都能达到 O(1) 的时间复杂度。通常,我们依然选择"尾部入队,头部出队"的策略。
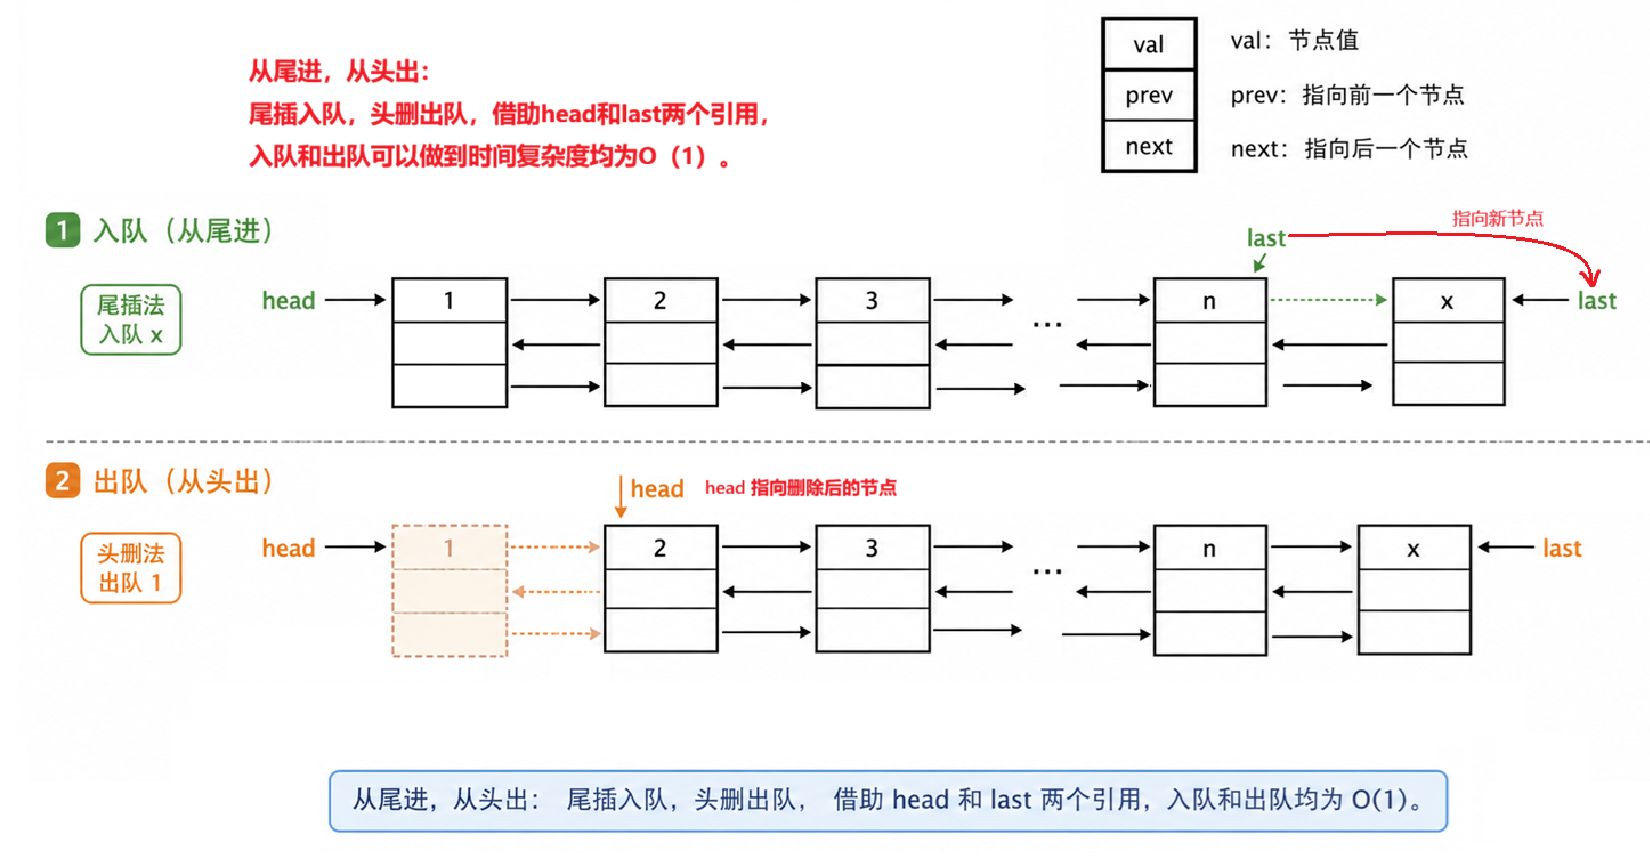
以下是使用 C++ 实现一个基于双向链表的队列示例:
#include <iostream>
#include <stdexcept> // For std::runtime_error

template <typename T>
class LinkedListQueue {
private:
    // 节点结构
    struct Node {
        T data;
        Node* prev;
        Node* next;

        Node(T val) : data(val), prev(nullptr), next(nullptr) {}
    };

    Node* queueFront; // 队首指针
    Node* queueRear;  // 队尾指针
    int elementCount; // 队列中元素的数量

public:
    LinkedListQueue() : queueFront(nullptr), queueRear(nullptr), elementCount(0) {}

    // 析构函数:释放所有节点内存
    ~LinkedListQueue() {
        while (queueFront != nullptr) {
            Node* temp = queueFront;
            queueFront = queueFront->next;
            delete temp;
        }
        queueRear = nullptr; // 确保队尾指针也被清除
    }

    // 入队操作 (尾部插入)
    void enqueue(T value) {
        Node* newNode = new Node(value);
        if (isEmpty()) {
            queueFront = newNode;
            queueRear = newNode;
        } else {
            queueRear->next = newNode;
            newNode->prev = queueRear;
            queueRear = newNode;
        }
        elementCount++;
    }

    // 出队操作 (头部删除)
    T dequeue() {
        if (isEmpty()) {
            throw std::runtime_error("Queue is empty, cannot dequeue.");
        }
        T removedValue = queueFront->data;
        Node* oldFront = queueFront;
        queueFront = queueFront->next;

        if (queueFront != nullptr) {
            queueFront->prev = nullptr;
        } else {
            // 队列现在为空
            queueRear = nullptr;
        }
        delete oldFront;
        elementCount--;
        return removedValue;
    }

    // 获取队首元素
    T front() const {
        if (isEmpty()) {
            throw std::runtime_error("Queue is empty.");
        }
        return queueFront->data;
    }

    // 检查队列是否为空
    bool isEmpty() const {
        return elementCount == 0;
    }

    // 获取队列中元素数量
    int size() const {
        return elementCount;
    }
};

/*
// 示例用法
int main() {
    LinkedListQueue<int> myQueue;
    std::cout << "Is empty: " << myQueue.isEmpty() << std::endl; // 1 (true)

    myQueue.enqueue(10);
    myQueue.enqueue(20);
    myQueue.enqueue(30);

    std::cout << "Queue size: " << myQueue.size() << std::endl;   // 3
    std::cout << "Front element: " << myQueue.front() << std::endl; // 10

    std::cout << "Dequeued: " << myQueue.dequeue() << std::endl;  // 10
    std::cout << "Front element: " << myQueue.front() << std::endl; // 20
    std::cout << "Queue size: " << myQueue.size() << std::endl;   // 2

    myQueue.enqueue(40);
    std::cout << "Dequeued: " << myQueue.dequeue() << std::endl;  // 20
    std::cout << "Dequeued: " << myQueue.dequeue() << std::endl;  // 30
    std::cout << "Dequeued: " << myQueue.dequeue() << std::endl;  // 40

    std::cout << "Is empty: " << myQueue.isEmpty() << std::endl; // 1 (true)
    // myQueue.dequeue(); // 抛出异常:Queue is empty, cannot dequeue.
    return 0;
}
*/
通过维护 queueFront 和 queueRear 两个指针,双向链表队列的入队和出队操作都能在 O(1) 时间内完成。
2. 顺序结构实现(数组)
数组可以作为队列的底层存储结构。在数组中,我们通常使用两个索引:frontIndex 指向队首元素,rearIndex 指向队尾下一个可插入位置。
- 入队:在
array[rearIndex]处放置元素,然后rearIndex++。 - 出队:移动
frontIndex++。
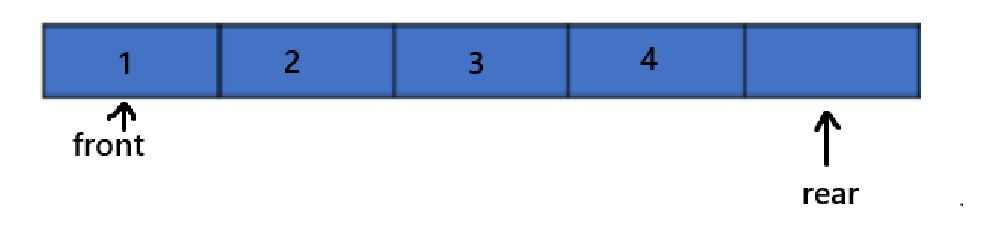
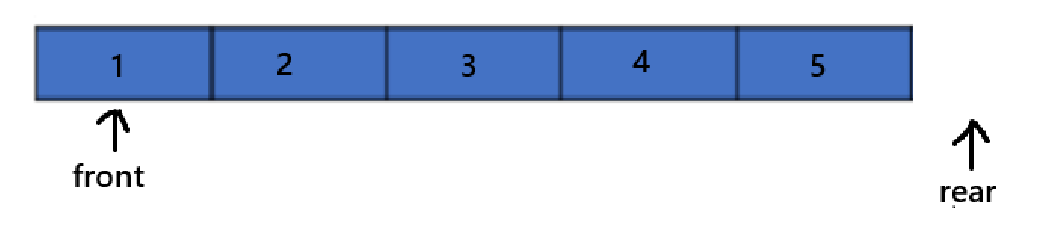
这种朴素的数组实现会很快遇到"假溢出"问题。例如,当元素不断出队,frontIndex 不断右移,数组左侧会产生空闲空间;而当 rearIndex 达到数组末尾时,即使左侧有空位,也无法再入队,报告"满"状态。这造成了空间浪费。
出队若干元素后:
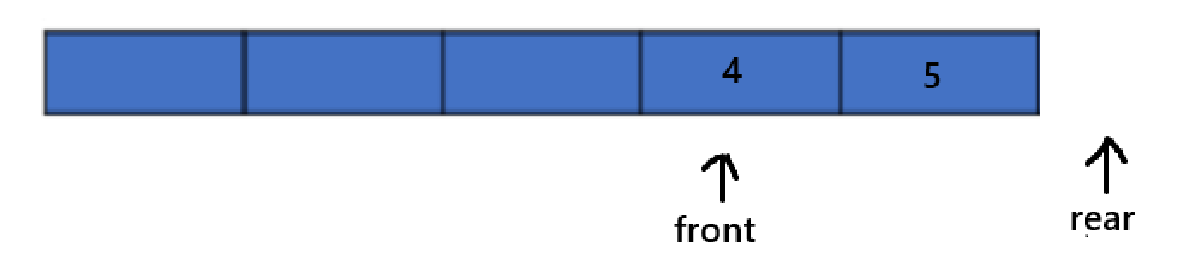
为解决假溢出问题,我们引入了"循环队列"的概念。
循环队列
循环队列将数组逻辑上视为一个环形结构,通过模运算(取余)使得索引在达到数组末尾时能够"绕回"到数组开头。这有效地利用了数组的所有空间。
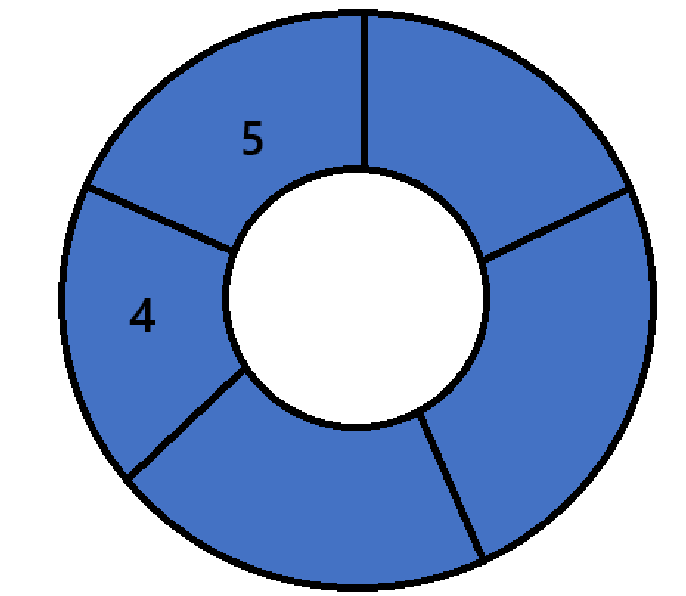
索引计算:
- 向前移动:
(当前索引 + 步数) % 数组长度。 - 向后移动(例如获取
rearIndex前一个元素):(当前索引 - 1 + 数组长度) % 数组长度,加数组长度是为了处理当前索引 - 1为负数的情况。
判空与判满
在循环队列中,frontIndex == rearIndex 既可能表示队列为空,也可能表示队列已满且绕了一圈。为了区分这两种情况,通常有以下策略:
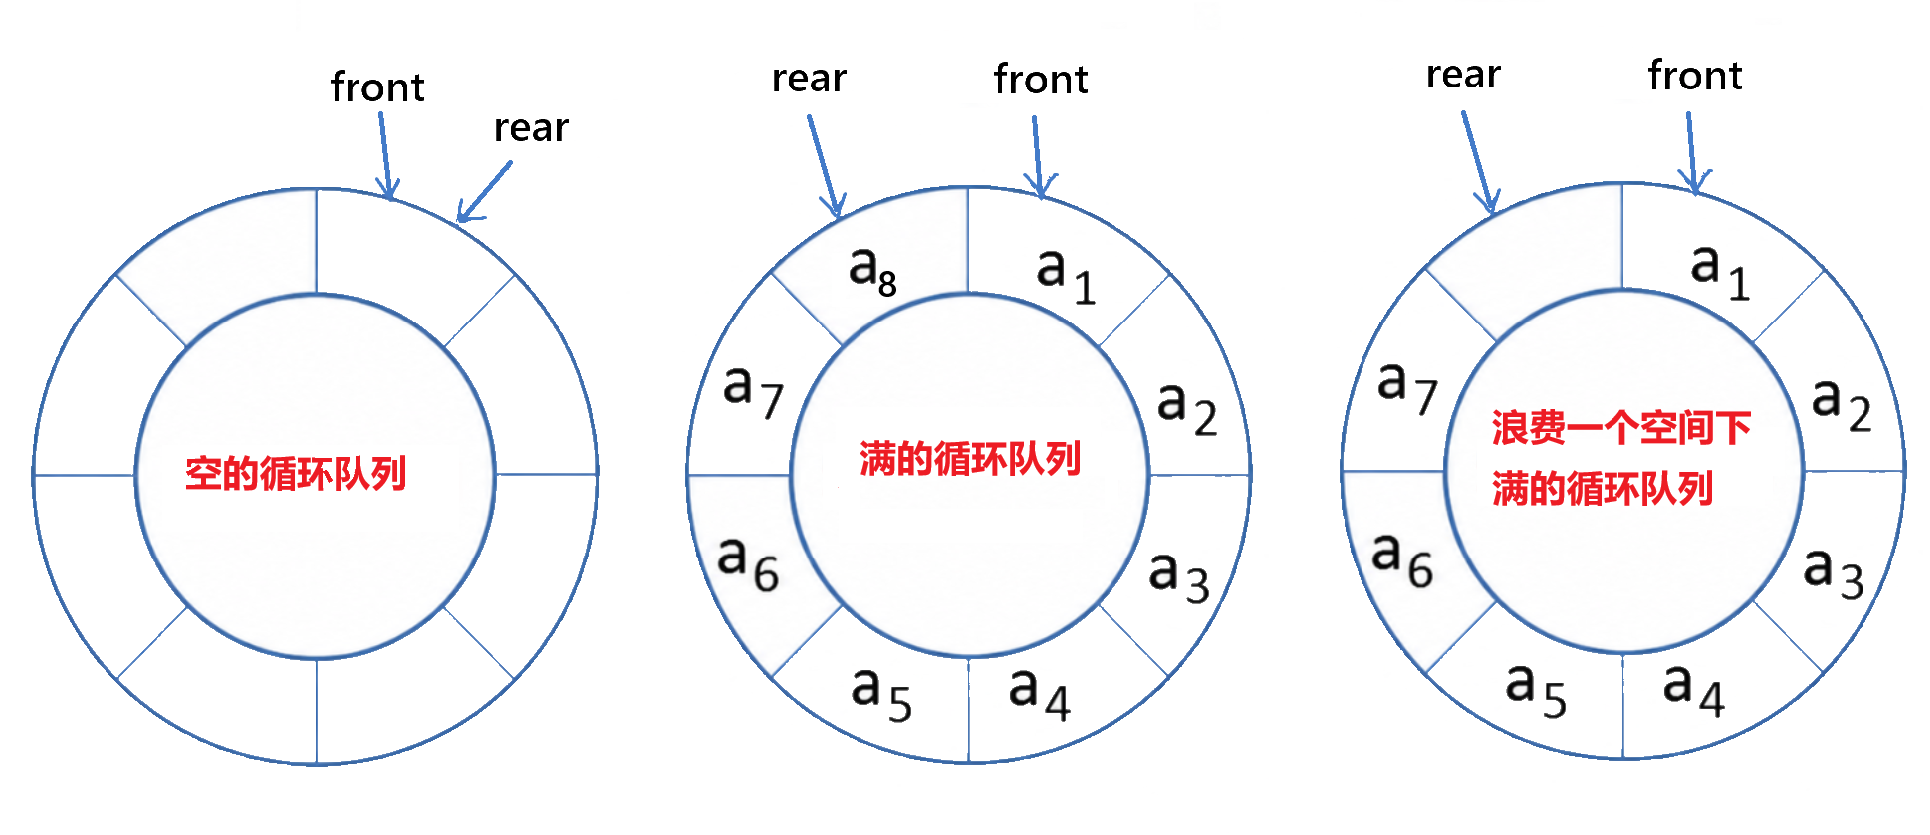
- 浪费一个存储单元:队列的实际容量比声明容量少1。当
(rearIndex + 1) % 数组长度 == frontIndex时,队列被认为是满的。此时,frontIndex == rearIndex表示队列为空。 - 使用一个计数器:维护一个
count变量记录队列中元素的实际数量。当count == 0时为空,当count == 数组长度时为满。 - 使用一个布尔标记:额外引入一个
isFull标记,当入队操作后将其设为真,出队操作后设为假,配合frontIndex == rearIndex来判断。
以下示例将采用第一种策略(浪费一个存储单元)。
C++ 实现循环队列
核心思想:维护 frontIndex(队首元素的索引)和 rearIndex(下一个入队位置的索引)。入队时在 rearIndex 处放置元素,出队时移动 frontIndex。所有索引操作都通过模运算实现循环。
#include <vector>
#include <stdexcept> // For std::runtime_error

template <typename T>
class CircularArrayQueue {
private:
    std::vector<T> dataStore; // 存储元素的数组
    int frontIndex;          // 队首元素的索引
    int rearIndex;           // 队尾下一个可插入位置的索引
    int currentCapacity;     // 队列的当前容量 (实际可存储元素数量)

public:
    // 构造函数,k 为队列的最大容量。实际数组大小为 k+1,因为会浪费一个空间
    CircularArrayQueue(int k) : frontIndex(0), rearIndex(0) {
        if (k <= 0) {
            throw std::invalid_argument("Capacity must be positive.");
        }
        dataStore.resize(k + 1); // 额外分配一个空间用于区分满/空
        currentCapacity = k;     // 实际可存储k个元素
    }

    // 入队操作
    bool enqueue(T value) {
        if (isFull()) {
            // 如果满了,可以考虑扩容,这里暂时返回false
            // 如果需要自动扩容,可以调用 grow() 方法
            grow(); // 扩容并重试入队
            return enqueue(value);
            // return false; // 不扩容时直接返回false
        }
        dataStore[rearIndex] = value;
        rearIndex = (rearIndex + 1) % dataStore.size();
        return true;
    }

    // 出队操作
    bool dequeue() {
        if (isEmpty()) {
            return false;
        }
        frontIndex = (frontIndex + 1) % dataStore.size();
        return true;
    }

    // 获取队首元素
    T front() const {
        if (isEmpty()) {
            throw std::runtime_error("Queue is empty.");
        }
        return dataStore[frontIndex];
    }

    // 获取队尾元素
    T rear() const {
        if (isEmpty()) {
            throw std::runtime_error("Queue is empty.");
        }
        // rearIndex 指向下一个入队位置,所以队尾元素是其前一个位置
        return dataStore[(rearIndex - 1 + dataStore.size()) % dataStore.size()];
    }

    // 检查队列是否为空
    bool isEmpty() const {
        return frontIndex == rearIndex;
    }

    // 检查队列是否已满
    bool isFull() const {
        return (rearIndex + 1) % dataStore.size() == frontIndex;
    }

    // 获取当前队列中元素的数量
    int size() const {
        return (rearIndex - frontIndex + dataStore.size()) % dataStore.size();
    }

private:
    // 扩容方法
    void grow() {
        int oldSize = size(); // 当前队列中的元素数量
        int newCapacity = currentCapacity * 2;
        std::vector<T> newStore(newCapacity + 1); // 新数组,容量翻倍,同样留一个空位

        // 按照逻辑顺序,将旧数组中的元素复制到新数组的起始位置
        for (int i = 0; i < oldSize; ++i) {
            newStore[i] = dataStore[(frontIndex + i) % dataStore.size()];
        }

        dataStore = std::move(newStore); // 将新数组赋值给dataStore
        frontIndex = 0;                 // 重置队首指针
        rearIndex = oldSize;            // 重置队尾指针
        currentCapacity = newCapacity;  // 更新容量
    }
};

/*
// 示例用法
int main() {
    CircularArrayQueue<int> myQueue(3); // 可存储3个元素

    std::cout << "Is empty: " << myQueue.isEmpty() << std::endl; // 1 (true)

    myQueue.enqueue(10);
    myQueue.enqueue(20);
    myQueue.enqueue(30); // 队列已满

    std::cout << "Is full: " << myQueue.isFull() << std::endl;   // 1 (true)
    std::cout << "Queue size: " << myQueue.size() << std::endl;   // 3
    std::cout << "Front element: " << myQueue.front() << std::endl; // 10
    std::cout << "Rear element: " << myQueue.rear() << std::endl;   // 30

    myQueue.enqueue(40); // 触发扩容,现在可以存储
    std::cout << "After grow, size: " << myQueue.size() << std::endl; // 4
    std::cout << "New rear element: " << myQueue.rear() << std::endl; // 40

    myQueue.dequeue();
    std::cout << "Dequeued, front element: " << myQueue.front() << std::endl; // 20
    std::cout << "Queue size: " << myQueue.size() << std::endl;   // 3

    while (!myQueue.isEmpty()) {
        std::cout << "Dequeued: " << myQueue.front() << std::endl;
        myQueue.dequeue();
    }
    std::cout << "Is empty: " << myQueue.isEmpty() << std::endl; // 1 (true)

    return 0;
}
*/
关于扩容的注意事项
在循环队列中,由于元素在底层数组中可能不是连续存储的(例如,队首在索引5,队尾在索引2),直接使用像 C++ 的 std::vector::resize() 或 std::vector::reserve() 这样的方法,或者简单地 realloc,并不能保证元素在新分配的空间中保持正确的逻辑顺序。如果仅仅扩容底层数组,而没有重新排列元素,那么 frontIndex 和 rearIndex 就会指向旧的、不连续的逻辑位置,导致后续的入队出队操作错误。
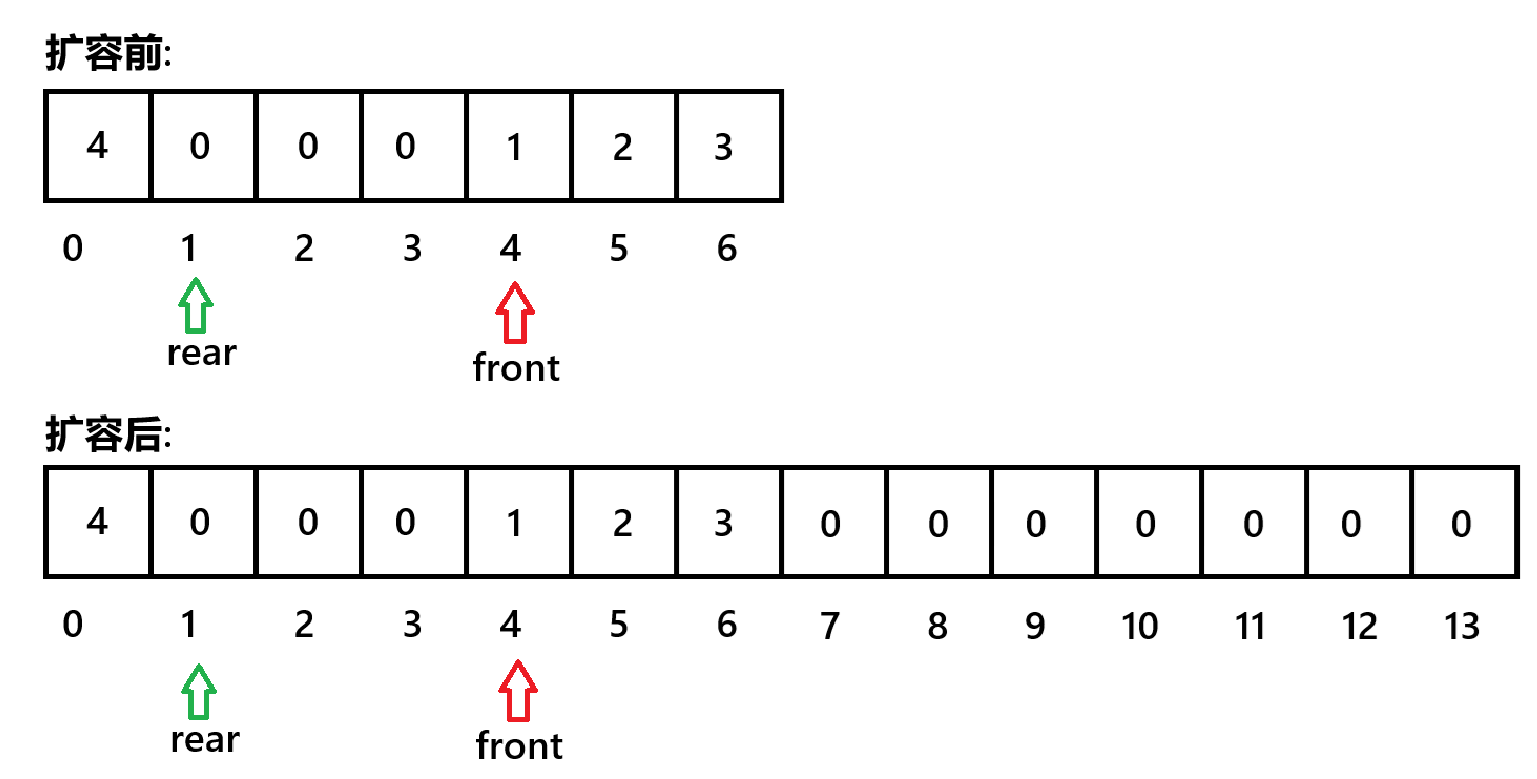
如上图所示,扩容前物理地址不连续的元素 4,在扩容后如果只是简单复制底层数组,它的逻辑位置就可能出错。
因此,在循环队列扩容时,必须手动将旧数组中的有效元素按照其逻辑顺序复制到一个新的、更大的连续数组中,并随后重置 frontIndex = 0 和 rearIndex = size,以确保新队列的逻辑连续性。
链式队列与顺序队列的比较
下表总结了两种主要队列实现方式的特点:
| 对比维度 | 链式队列(双向链表) | 顺序队列(循环数组) |
|---|---|---|
| 入队/出队复杂度 | O(1),涉及指针操作 | O(1),仅移动索引和赋值 |
| 内存分配方式 | 动态分配,按需创建节点 | 预分配一块连续内存 |
| 空间利用率 | 每个节点有额外的指针开销 | 只有数据本身开销,空间利用率高 |
| 扩容代价 | 无需显式扩容,自然增长 | 需要创建新数组并搬移元素,O(N) |
| CPU 缓存友好性 | 节点分散,缓存局部性差 | 连续存储,缓存局部性好 |
| 实现复杂度 | 指针操作较多,边界条件需细致处理 | 主要依赖模运算,逻辑相对简洁 |
在实际应用中,例如 C++ 的 std::deque 和 Java 的 ArrayDeque 通常基于循环数组实现,因为它们在大多数场景下提供了更好的缓存性能。而像 std::list 或 java.util.LinkedList 则基于双向链表。
使用队列实现栈
LeetCode 225 题便是要求使用队列的数据结构来实现栈的功能。栈(Stack)遵循"后进先出"(LIFO)原则,与队列的 FIFO 原则相反,这就需要一些巧妙的设计。
核心思路:双队列法
我们可以使用两个队列来实现一个栈:一个主队列(q1)用于存储元素,另一个辅助队列(q2)用于在出栈时临时存放元素。
1. 模拟入栈 push(T value)
入栈操作非常简单,直接将元素添加到主队列 q1 的队尾即可。
2. 模拟出栈 pop()
出栈操作是关键:为了获取"最后进入"的元素(即栈顶),我们需要将 q1 中除最后一个元素之外的所有元素移动到 q2,然后取出 q1 中剩下的最后一个元素。最后,将 q1 和 q2 的角色互换,确保 q1 始终是存储元素的主队列。
#include <queue>
#include <stdexcept> // For std::runtime_error

template <typename T>
class MyStack {
private:
    std::queue<T> primaryQueue;   // 主队列,用于存储元素
    std::queue<T> auxiliaryQueue; // 辅助队列,用于出栈操作

public:
    MyStack() {}

    // 入栈操作
    void push(T value) {
        primaryQueue.push(value);
    }

    // 出栈操作
    T pop() {
        if (isEmpty()) {
            throw std::runtime_error("Stack is empty, cannot pop.");
        }

        // 将 primaryQueue 中除最后一个元素外的所有元素移动到 auxiliaryQueue
        while (primaryQueue.size() > 1) {
            auxiliaryQueue.push(primaryQueue.front());
            primaryQueue.pop();
        }

        // primaryQueue 中现在只剩一个元素,即栈顶元素
        T topValue = primaryQueue.front();
        primaryQueue.pop();

        // 交换 primaryQueue 和 auxiliaryQueue,使 primaryQueue 再次成为主队列
        std::swap(primaryQueue, auxiliaryQueue);
        return topValue;
    }

    // 获取栈顶元素
    T top() {
        if (isEmpty()) {
            throw std::runtime_error("Stack is empty.");
        }

        // 将 primaryQueue 中除最后一个元素外的所有元素移动到 auxiliaryQueue
        while (primaryQueue.size() > 1) {
            auxiliaryQueue.push(primaryQueue.front());
            primaryQueue.pop();
        }

        // primaryQueue 中现在只剩一个元素,即栈顶元素
        T topValue = primaryQueue.front();

        // 将这个栈顶元素也移动到 auxiliaryQueue,然后交换队列
        auxiliaryQueue.push(topValue);
        primaryQueue.pop(); // 清空 primaryQueue

        // 交换 primaryQueue 和 auxiliaryQueue
        std::swap(primaryQueue, auxiliaryQueue);
        return topValue;
    }

    // 检查栈是否为空
    bool isEmpty() const {
        return primaryQueue.empty();
    }
};

/*
// 示例用法
int main() {
    MyStack<int> myStack;
    std::cout << "Stack is empty: " << myStack.isEmpty() << std::endl; // 1 (true)

    myStack.push(1);
    myStack.push(2);
    myStack.push(3);

    std::cout << "Top element: " << myStack.top() << std::endl;    // 3
    std::cout << "Popped element: " << myStack.pop() << std::endl; // 3
    std::cout << "Top element: " << myStack.top() << std::endl;    // 2

    myStack.push(4);
    std::cout << "Top element: " << myStack.top() << std::endl;    // 4
    std::cout << "Popped element: " << myStack.pop() << std::endl; // 4
    std::cout << "Popped element: " << myStack.pop() << std::endl; // 2
    std::cout << "Popped element: " << myStack.pop() << std::endl; // 1
    std::cout << "Stack is empty: " << myStack.isEmpty() << std::endl; // 1 (true)

    // myStack.pop(); // 抛出异常:Stack is empty, cannot pop.
    return 0;
}
*/
使用栈实现队列
与使用队列实现栈类似,我们也可以使用两个栈来实现一个队列。核心思想是:一个栈(stackIn)负责入队操作,另一个栈(stackOut)负责出队操作。当 stackOut 为空时,将 stackIn 中的所有元素倒入 stackOut,这样元素的顺序就反转了两次,恢复了 FIFO 的特性,然后从 stackOut 弹出元素。
双端队列 (Deque)
概念
双端队列(Double-Ended Queue,简称 Deque)是一种更为灵活的线性数据结构,它允许在队列的两端(队首和队尾)进行插入和删除操作。因此,双端队列既可以作为队列(FIFO)使用,也可以作为栈(LIFO)使用。
C++ STL 中的 Deque 接口
C++ 标准库提供了 std::deque 容器,它是一个模板类,可以像向量一样随机访问元素,但同时支持在两端高效地插入和删除。以下是其一些常用操作:
| 队首操作 | 队尾操作 | |
|---|---|---|
| 插入 | push_front(value) |
push_back(value) |
| 删除 | pop_front() |
pop_back() |
| 查看 | front() |
back() |
作为栈使用:
将双端队列的某一端(例如队首)作为栈顶。push_front 对应入栈,pop_front 对应出栈。
#include <deque>
#include <iostream>

int main() {
    std::deque<int> myStack;
    myStack.push_front(1); // 入栈
    myStack.push_front(2); // 入栈
    std::cout << "Popped from stack: " << myStack.front() << std::endl; // 2
    myStack.pop_front(); // 出栈
    return 0;
}
作为队列使用:
将一端作为队首,另一端作为队尾。push_back 对应入队,pop_front 对应出队。
#include <deque>
#include <iostream>

int main() {
    std::deque<int> myQueue;
    myQueue.push_back(1); // 入队
    myQueue.push_back(2); // 入队
    std::cout << "Dequeued from queue: " << myQueue.front() << std::endl; // 1
    myQueue.pop_front(); // 出队
    return 0;
}
std::deque 与 std::list 的对比
C++ STL 中,std::deque 和 std::list 都可以实现队列和栈的功能,但它们的底层实现和性能特性有所不同:
std::deque (双端队列) |
std::list (双向链表) |
|
|---|---|---|
| 底层结构 | 分段的动态数组(通常是块状数组) | 双向链表 |
| 栈/队列操作 | O(1) | O(1) |
| 内存 | 逻辑上连续,物理上分段,缓存友好性较好 | 节点分散,缓存局部性差 |
| 扩容 | 内部管理分段数组,扩容通常高效,无需整体搬移 | 无需扩容,按需分配节点 |
| 随机访问 | O(1)(支持 [] 运算符) |
O(N)(需遍历) |
| 中间插入/删除 | O(N) | O(1)(如果已知迭代器) |
对于大部分需要栈或队列功能的场景,C++ 推荐优先使用 std::deque 而不是 std::stack 或 std::queue(它们默认底层也用 std::deque),因为 std::deque 通常在性能和功能上提供了更好的平衡,尤其是其在两端的 O(1) 操作和较好的缓存局部性。
