MySQL 联合索引设计与最左匹配原则实战
业务背景分析
在数据驱动的应用中,随着数据量的激增,查询性能的优化变得至关重要。假设我们正在开发一个视频检索系统,用户可以通过多个维度筛选内容。常见的筛选条件包括:视频大类、子类、关联产品类型、具体产品以及品牌。此外,还有视频长度和发布时间等过滤项。
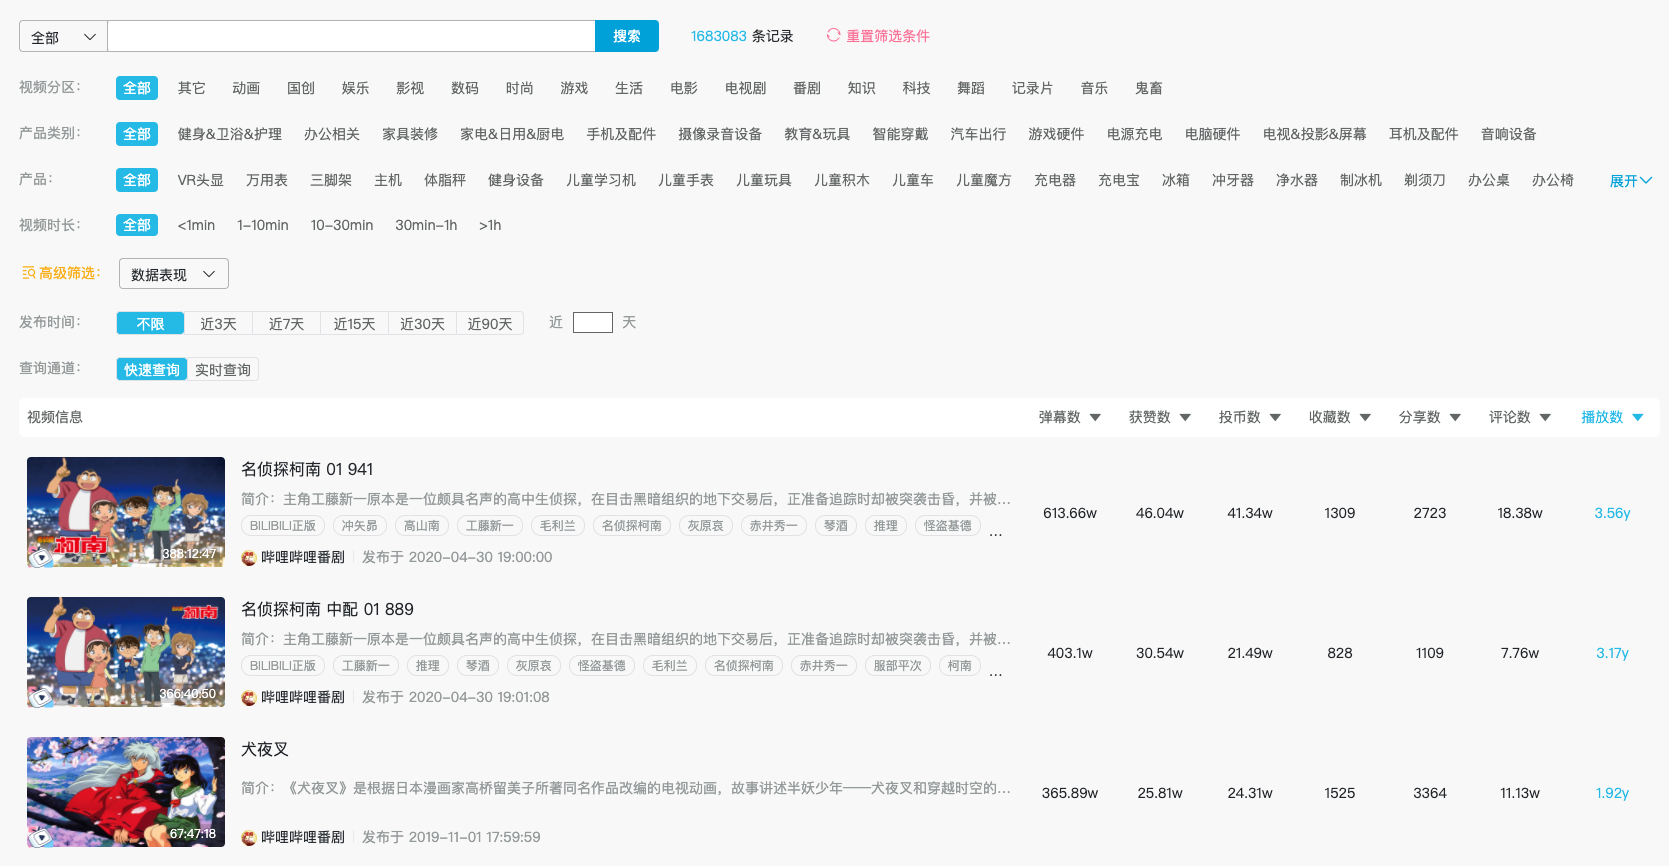
这些筛选条件具有层级关系,例如:
- 视频分区 (zone_id) > 子分区 (sub_zone_id)
- 产品类别 (cat_id) > 具体产品 (item_id) > 品牌 (brand_id)
在实际操作中,用户可能会根据不同的逻辑组合这些条件。常见的查询组合包括:
- 全路径筛选:分区 + 子分区 + 类别 + 产品 + 品牌
- 分类快速筛选:分区 + 子分区 + 类别
- 品牌导向筛选:产品 + 品牌
- 混合筛选:分区 + 类别 + 产品 + 品牌
面对如此多样的查询组合,如何设计高效的索引是提升数据库响应速度的关键。
联合索引的设计误区
在处理多条件查询时,开发者往往容易陷入两个极端:
1. 盲目创建单列索引
为每一个查询字段都单独建立索引:
CREATE INDEX idx_zone ON video_metadata (zone_id);
CREATE INDEX idx_sub_zone ON video_metadata (sub_zone_id);
CREATE INDEX idx_cat ON video_metadata (cat_id);
-- ...以此类推
这种做法在 MySQL 中虽然可能触发"索引合并(Index Merge)",但其效率远不如精心设计的联合索引,且增加了索引维护的开销。
2. 过于理想化的长索引
创建一个包含所有字段的巨大联合索引:
CREATE INDEX idx_full_search ON video_metadata (zone_id, sub_zone_id, cat_id, item_id, brand_id);虽然这种索引覆盖面广,但它受限于 MySQL 的最左匹配原则(Leftmost Prefix Rule)。
深入理解最左匹配原则
联合索引的生效逻辑是从索引定义的最左侧列开始逐一匹配的。如果查询条件中跳过了索引的前缀列,索引将失效。
- 完全匹配:
WHERE zone_id = 1 AND sub_zone_id = 2 AND cat_id = 3可以完美利用上述idx_full_search。 - 前缀匹配:
WHERE zone_id = 1 AND sub_zone_id = 2依然有效,符合最左前缀原则。 - 中间断档:
WHERE zone_id = 1 AND cat_id = 3(跳过了 sub_zone_id),此时只能利用到zone_id部分的索引,后续的cat_id无法通过索引加速。 - 首列缺失:
WHERE item_id = 10 AND brand_id = 5这种情况下,idx_full_search完全失效,因为最左侧的zone_id不在查询条件中。
基于实战的索引优化策略
为了在实际项目中最大限度地利用索引,我们需要根据业务逻辑对查询频率最高的组合进行分析,并建立多个针对性的联合索引。例如,针对上述视频系统,可以考虑如下方案:
-- 方案:针对视频层级深度查询
CREATE INDEX idx_zone_hierarchy ON video_metadata (zone_id, sub_zone_id, cat_id);

-- 方案:针对产品层级深度查询
CREATE INDEX idx_product_hierarchy ON video_metadata (item_id, brand_id);

-- 方案:针对时间维度的排序与过滤
CREATE INDEX idx_zone_publish ON video_metadata (zone_id, publish_time);
这种"折中"的方案通过创建 2-3 个核心联合索引,可以覆盖 80% 以上的高频查询场景。在设计时,应将区分度高(唯一性强)的字段放在联合索引的前面。
索引的局限性:模糊查询
需要注意的是,即使建立了联合索引,某些查询方式依然无法被优化。最典型的就是以通配符开头的模糊查询:
-- 这种方式无法利用索引
SELECT * FROM video_metadata WHERE title LIKE '%MySQL%';
在处理这种 %keyword% 模式的文本搜索时,B-tree 索引无法通过前缀定位数据。针对这种场景,通常需要引入搜索引擎(如 Elasticsearch)或使用 MySQL 的全文索引(Full-Text Index)来解决。
