从源代码到可执行程序:编译、链接与加载机制深度解析
在现代软件开发中,随着Java、Python、PHP等高级语言及其运行时环境(如JVM、解释器)的普及,工程师们往往无需直接与操作系统底层进行交互。这些虚拟机或解释器提供了一个强大的抽象层,极大地提升了开发效率。然而,这种便利也可能导致开发者对程序从源代码到最终运行的可执行文件之间的编译、链接、加载过程感到陌生。当需要进行性能优化、系统级调试或理解底层交互时,缺乏对这些机制的了解可能会成为瓶颈。
本文旨在为读者全面剖析程序源代码如何转化为可在操作系统上执行的二进制文件,并深入探讨编译、链接与加载过程中的核心原理。
- 首先,我们将概述不同CPU架构及操作系统对应的可执行文件格式。
- 其次,通过具体的C语言代码示例,详细阐述编译器和链接器对源代码的处理方式。
- 最后,我们会探讨程序执行时,加载器的工作原理以及操作系统提供的相关支持。
CPU指令集架构
当前我们日常使用的个人电脑或服务器CPU多采用X86_64指令集架构,这属于复杂指令集计算机(CISC)范畴。在计算机组成原理课程中我们了解到,除了CISC,还有另一种精简指令集计算机(RISC),例如ARM、MIPS或IBM的PowerPC指令集。我们无需深究各类架构的细节,更关键的问题是:为一种CPU架构编译的代码,能否在另一种架构上运行?
答案是否定的。二进制程序本质上是由一系列CPU指令构成,程序执行时,CPU会逐条加载并执行这些指令。不同的CPU架构拥有各自独特的指令集,它们在指令长度、格式和语义上都存在差异。因此,让一个基于ARM指令集编译的二进制程序在X86_64架构的CPU上运行是不可行的。
操作系统与二进制文件格式
Java语言当年之所以迅速崛起,其"一次编写,到处运行"的跨平台特性是重要卖点之一。这得益于Java源代码经Javac编译后生成的字节码,可以在装有对应Java虚拟机的Windows、Linux或macOS等不同操作系统上运行。那么,为何由GCC/G++编译的二进制程序通常不能跨平台执行呢?
既然Java程序通过统一的字节码和多平台JVM实现了跨平台,我们自然可以推断,不同操作系统之间二进制程序无法直接互通,是因为它们所使用的二进制文件格式不尽相同。
事实的确如此。程序编译为二进制文件后,其运行时入口通常是main函数。但程序如何被载入内存?执行流又如何精确地定位到main函数的起始地址?这些都是操作系统在背后完成的工作。在main函数执行之前,操作系统会进行一系列准备:分配虚拟地址空间、将二进制文件中的代码和数据加载到该空间、根据特定的文件格式定位初始化段以完成环境变量设置、全局变量处理等预备工作,最终才将控制权转交给main函数。这里的"特定的文件格式"正是导致二进制程序无法跨平台运行的根本原因。
简而言之,每个操作系统都定义了自己独有的二进制文件格式。当操作系统加载可执行程序时,它会依据这些默认格式来解析文件结构,寻找代码段、数据段、初始化段等关键信息。因此,Windows下的PE(Portable Executable)格式可执行文件(.exe)、静态库(.lib)和动态库(.dll)无法直接在Linux系统上运行;macOS下的Mach-O格式可执行文件、静态库(.a)和动态库(.dylib)也无法在Linux上直接运行。反之亦然,Linux下的ELF(Executable and Linkable Format)格式可执行文件、静态库(.a)和动态库(.so)也无法在Windows系统上直接运行。
源代码的编译阶段
了解了CPU架构和操作系统对二进制文件格式的影响后,我们接下来将探讨源代码文件如何经过处理,最终成为一个可执行文件。尽管不同系统(如Windows下的Visual C++编译器,Linux/Unix下的GCC/G++)和不同编程语言(各自拥有专用编译器)在实现细节上有所差异,但它们的基本工作原理和流程是相通的。鉴于Linux和C/C++语言的广泛应用,本文后续内容将以Linux平台上的GCC/G++编译器编译C/C++源代码为例进行说明。
本文的重点在于理解源代码如何通过编译器、链接器和加载器最终以进程形式运行在系统中,因此不会深入探讨编译器内部的词法分析、语法分析和语义分析等过程。我们将主要关注GCC/G++如何将C/C++代码转化为Linux系统识别的ELF可执行文件。
C语言源文件的基本元素
首先,我们回顾C语言程序中变量和函数的基本概念。
声明与定义:
- 声明一个变量或函数,是告诉编译器该符号可能在当前源文件中使用,但其具体实现或存储空间在其他文件中。编译器在编译当前文件时不会因为找不到定义而报错。
- 定义一个变量,是为该变量在生成的目标文件中预留存储空间,并可选地初始化其值。
- 定义一个函数,是在目标文件中生成该函数的二进制机器码。
变量类型与作用域:
- 非静态全局变量: 存在于程序整个生命周期,可被所有源文件访问。
- 静态全局变量(
static): 存在于程序整个生命周期,但其作用域仅限于定义它的源文件内部。 - 非静态局部变量: 仅在其所在函数执行时存在(通常在函数栈帧中)。
- 静态局部变量(
static): 属于全局变量范畴,存在于程序整个生命周期,但其作用域被限制在定义它的代码块中。 - 动态分配变量: 在程序运行时通过
malloc等函数从堆区申请内存。
函数类型与作用域:
- 非静态函数: 全局函数,可被其他源文件调用。
- 静态函数(
static): 作用域限制在定义它的源文件内部。
我们通过以下C语言程序示例,观察编译器如何处理这些变量和函数:
#include <stdio.h>

// 定义一个已初始化的全局变量
int global_initialized_var = 100;
// 定义一个未初始化的全局变量
int global_uninitialized_var;
// 定义一个静态全局变量
static int static_global_counter = 0;

// 声明一个外部变量,其定义在其他文件
extern int external_data_value;

// 声明一个外部函数,其定义在其他文件
extern int compute_external_result(int val1, int val2);

// 定义一个内部函数
int multiply(int a, int b) {
    return a * b;
}

int main(int argc, char* argv[]) {
    // 局部静态变量
    static int local_static_accumulator = 0;
    // 栈上的局部变量
    int stack_var = 20;

    global_uninitialized_var = 50; // 为未初始化全局变量赋值
    static_global_counter++;       // 访问静态全局变量
    local_static_accumulator += multiply(global_initialized_var, stack_var); // 调用内部函数

    // 调用外部函数并使用外部变量
    int final_result = compute_external_result(local_static_accumulator, external_data_value);

    printf("Final result: %d\n", final_result);

    return 0;
}
目标文件与符号表
在通过GCC编译此程序之前,我们可以大致推测编译器为使其运行所需完成的工作:首先,将高级语言代码转换为CPU能理解的二进制指令;其次,为函数调用和条件跳转提供明确的目标地址;最后,为变量分配内存并提供访问其数据的地址。这意味着编译器需要为每个函数和变量生成一个唯一的标识(符号)及其对应的地址。
现在,我们将上述C源文件编译为目标文件并查看其符号信息:
gcc -c example1.c -o example1.o
nm example1.o
执行nm example1.o后,我们可能会看到类似以下的输出(地址和顺序可能因编译环境和版本而异):
                 U compute_external_result
0000000000000000 D global_initialized_var
0000000000000004 C global_uninitialized_var
                 U external_data_value
000000000000002b T main
0000000000000000 T multiply
0000000000000004 b local_static_accumulator.1234
0000000000000000 b static_global_counter
nm命令的输出通常包含三列:最左侧是符号在所在段中的相对地址,中间是符号类型(表示所在的段类型),最右侧是符号名称。
- 相对地址: 符号在目标文件中各自段内的偏移量。例如,
global_initialized_var和static_global_counter可能拥有相同的相对地址,但它们位于不同的段中(D段和b段),因此不会冲突。 - 符号类型(段类型):
D:已初始化的数据段,存放已初始化的全局变量(如global_initialized_var)。C:未初始化的数据段(Common section),存放未初始化的全局变量(如global_uninitialized_var)。在最终链接时,它们通常会被放入BSS(Block Started by Symbol)段。b:BSS段,存放未初始化或零初始化的静态数据(如static_global_counter,local_static_accumulator)。T:代码段(Text section),存放函数的机器码(如main,multiply)。U:未定义符号(Undefined),表示该符号在此目标文件中未定义,需要在其他目标文件或库中查找(如compute_external_result,external_data_value)。
值得注意的是,在同一个段中,符号的相对地址是唯一的。
- 符号名称: 这里我们看到
local_static_accumulator被编译器修改为local_static_accumulator.1234(数字后缀可能不同)。这是因为局部静态变量的作用域限制在定义它的代码块内,但其生命周期与程序相同,类似于全局变量。编译器通过添加唯一后缀来区分不同代码块中可能同名的局部静态变量。
external_data_value和compute_external_result没有地址,它们的符号类型为U。这印证了我们之前关于"声明"的讨论:它们是编译器留给链接器去其他文件或库中寻找定义的"承诺"。
通过这些信息,我们可以看出编译器的工作并非神秘莫测,它所做的每一步都是为了支持编程语言的特性,将源代码结构映射到可执行的机器指令和数据布局上。
目标文件的链接阶段
上一节我们探讨了C语言源文件的组成、编译器对其的处理及背后原理,并留下了一些待解决的未定义符号。本节将讨论当编译器将各个C源文件编译成目标文件后,链接器需要进行哪些处理。
首先,我们尝试将上一节生成的目标文件example1.o直接链接成可执行文件:
gcc example1.o -o program
链接器会报错,提示"undefined reference to `compute_external_result'"和"undefined reference to `external_data_value'"。这是因为我们声明的外部变量和函数在当前目标文件中找不到定义。为了解决这个问题,我们创建另一个C源文件example2.c来提供它们的定义:
#include <stdio.h>

// 定义在example1.c中声明的外部变量
int external_data_value = 42;

// 定义在example1.c中声明的外部函数
int compute_external_result(int val1, int val2) {
    return val1 + val2;
}
将此文件编译为目标文件并查看其符号表:
gcc -c example2.c -o example2.o
nm example2.o
输出将显示:
0000000000000000 T compute_external_result
0000000000000000 D external_data_value
现在,我们将这两个目标文件链接成一个可执行文件:
gcc example1.o example2.o -o program
nm program
此时,nm program的输出会比单个目标文件多出许多信息,包括系统库函数及为了实现程序功能而创建的各种段。其中,我们可以找到源文件中定义的变量和函数的符号及其在内存中的绝对地址(地址值将是真实的运行时虚拟地址):
...
00000000004005e8 T _fini
0000000000400390 T _init
00000000004003d0 T _start
...
000000000040062a T compute_external_result
0000000000601040 D external_data_value
0000000000601020 D global_initialized_var
0000000000601050 B global_uninitialized_var
0000000000601048 b local_static_accumulator.1234
000000000040063f T main
0000000000400619 T multiply
0000000000601044 b static_global_counter
...
从最终的可执行文件中,我们可以观察到:
- 之前在
example1.c中声明的external_data_value和compute_external_result符号,现在已在example2.o中找到了实际定义并被链接到一起。 - 不同目标文件中定义的同类型段(如
global_initialized_var和external_data_value都位于D数据段,而main和multiply位于T代码段)被合并,并为其分配了唯一的绝对虚拟地址。 - 目标文件中的相对地址全部转换为可执行文件中的绝对地址。
因此,链接器(linker)的核心功能总结如下:
- 符号解析: 在多个目标文件及库中寻找未定义符号的定义,将它们关联起来。
- 段合并: 将各个目标文件中同类型的代码段、数据段等合并成可执行文件中的逻辑段。
- 地址重定位: 将目标文件中基于零的相对地址,根据最终合并后的内存布局,修正为程序运行时在虚拟地址空间中的实际绝对地址。
这些是链接器实现程序构建最基本且至关重要的功能。
程序的加载与运行
前几节我们讨论了编译器如何将C源文件编译成目标文件,以及链接器如何将多个目标文件链接成可执行文件。本节将深入探讨可执行文件如何被操作系统加载并最终运行。
动态链接库机制
在实际编程中,我们通常不会自己实现所有功能,而是依赖系统库和第三方库。前面示例代码为简化说明,并未调用库函数。现在,假设我们需要调用标准C库中的函数,可执行文件又会呈现何种面貌?看下面这个示例:
#include <stdio.h>
#include <string.h> // 包含字符串处理函数

int main() {
    char buffer[64];
    const char* message = "Hello, dynamic linking world!";

    // 使用strcpy复制字符串
    strcpy(buffer, message);

    // 使用printf打印字符串和其长度
    printf("Copied message: %s (Length: %zu)\n", buffer, strlen(buffer));

    return 0;
}
我们编译此文件并查看其符号表:
gcc example3.c -o program3
nm program3
输出中,我们将再次看到U类型的符号,但这次它们出现在一个已链接完成的可执行文件中:
00000000004005b4 T main
                 U printf@@GLIBC_2.2.5
                 U strcpy@@GLIBC_2.2.5
                 U strlen@@GLIBC_2.2.5
这些未定义的符号为何会出现在一个可执行文件中?这正是为了支持动态链接库功能。动态链接库(Dynamic Link Library, DLL,在Linux上通常是.so文件)的特点是:程序在运行时才去定位并加载这些库,将它们映射到进程的虚拟地址空间。同一动态链接库的物理内存副本可以被多个进程共享,从而节省内存。
动态链接器如何处理对这些库函数的调用呢?我们可以用objdump -D program3 | less命令查看汇编代码,搜索printf和strcpy:
0000000000400490 <strcpy@plt>:
  400490:       ff 25 6a 0b 20 00       jmpq   *0x200b6a(%rip)        # 601000 <_GLOBAL_OFFSET_TABLE_+0x18>
  400496:       68 00 00 00 00          pushq  $0x0
  40049b:       e9 e0 ff ff ff          jmpq   400480 <_init+0x20>
...
00000000004004b0 <printf@plt>:
  4004b0:       ff 25 5a 0b 20 00       jmpq   *0x200b5a(%rip)        # 601010 <_GLOBAL_OFFSET_TABLE_+0x28>
  4004b6:       68 02 00 00 00          pushq  $0x2
  4004bb:       e9 c0 ff ff ff          jmpq   400480 <_init+0x20>
我们发现,可执行文件中为strcpy和printf生成了代理符号(位于PLT,Procedure Linkage Table)。首次调用时,这些代理符号会跳转到Global Offset Table (GOT)中的一个地址。GOT中的地址初始指向PLT的下一条指令,该指令会将库函数的ID压栈并跳转到动态链接器的入口。动态链接器会解析并加载实际的库函数,然后将GOT中对应的条目更新为该函数在内存中的实际地址。此后再次调用该函数时,将直接通过GOT跳转到实际的函数地址,实现了延迟绑定(Lazy Binding)和地址无关代码(PIC)的特性。
Linux提供了ldd命令来查看一个可执行文件所依赖的动态链接库:
ldd program3
输出类似:
    linux-vdso.so.1 =>  (0x00007fff413ff000)
    libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007fe202ae7000)
    /lib64/ld-linux-x86-64.so.2 (0x00007fe202eb2000)
ldd命令模拟加载过程,显示动态库及其被映射的虚拟地址。每次运行ldd,这些地址可能不同,因为它们是动态定位的。这个命令在排查程序因缺少动态库或库版本不兼容而报错时非常有用。
若我们在程序中加入sleep(1000);并在其运行时查看/proc/PID/maps文件(PID为进程ID),可以观察到动态链接库在进程地址空间中的映射:
7feeef61f000-7feeef7d4000 r-xp 00000000 fd:01 135891                     /lib/x86_64-linux-gnu/libc-2.15.so
7feeef7d4000-7feeef9d3000 ---p 001b5000 fd:01 135891                     /lib/x86_64-linux-gnu/libc-2.15.so
7feeef9d3000-7feeef9d7000 r--p 001b4000 fd:01 135891                     /lib/x86_64-linux-gnu/libc-2.15.so
7feeef9d7000-7feeef9d9000 rw-p 001b8000 fd:01 135891                     /lib/x86_64-linux-gnu/libc-2.15.so
libc库被映射到进程地址空间的不同段,每个段拥有不同的权限(读、执行、写等)。程序对这些库函数的调用最终会跳转到这些映射的地址。
综上,链接器在处理动态链接库时主要完成以下工作:
- 在链接目标文件为可执行文件时,如果遇到未定义的变量或函数,链接器会根据预设的动态库搜索路径查找动态库中对应的定义。
- 一旦在动态库中找到定义,链接器会将该动态库的依赖信息写入可执行文件,并为该变量或函数生成一个代理符号(PLT条目)。
- 在程序运行时,通过
_GLOBAL_OFFSET_TABLE_(GOT)和PLT机制,实现对库函数的动态地址解析和跳转。
尽管静态链接库(.a文件)的行为与目标文件类似,但由于其将库代码直接嵌入每个可执行文件,导致库升级复杂、资源占用高等问题,目前使用已相对较少,故此处不再深入探讨。
从_start到main的执行路径
在"操作系统"一节中,我们提到main函数执行前会有一系列初始化工作。在"动态链接库"一节中,我们了解到动态库需要在程序启动时链接。现在,我们将这些步骤综合起来,从ELF文件的角度跟踪Linux系统如何加载可执行文件并最终调用到main函数。
在"目标文件的链接"一节的nm program输出中,我们看到了_start符号。对于ELF文件格式,Linux系统在为进程分配完虚拟地址空间并加载代码到内存后,会从_start对应的地址开始执行。这个地址记录在ELF文件的头部,由系统加载时获取。让我们从_start处的指令开始追踪关键执行点:
0000000000400510 <_start>:
  ...
  400526:       48 c7 c1 70 06 40 00    mov    $0x400670,%rcx       /* __libc_csu_init 地址 */
  40052d:       48 c7 c7 f4 05 40 00    mov    $0x4005f4,%rdi       /* main 函数地址 */
  400534:       e8 b7 ff ff ff          callq  4004f0 <__libc_start_main@plt>
  /* _start 段会调用libc库中的__libc_start_main指令,
     注意传递给它的两个参数,一个是__libc_csu_init的地址,一个是main函数的地址。 */
  ...

00000000004004f0 <__libc_start_main@plt>:
  4004f0:       ff 25 22 0b 20 00       jmpq   *0x200b22(%rip)        # 601018 <_GLOBAL_OFFSET_TABLE_+0x30>
  /* 此处跳转到GOT,进而由动态链接器定位到libc中真正的__libc_start_main。*/

0000000000400670 <__libc_csu_init>:
  ...
  4006b0:       e8 e3 fd ff ff          callq  400498 <_init>
  /* __libc_csu_init 会调用 _init 函数。 */
  ...

0000000000400498 <_init>:
  ...
  4004a6:       e8 65 02 00 00          callq  400710 <__do_global_ctors_aux>
  /* _init 函数中可能会调用 __do_global_ctors_aux 等,用于全局对象的构造等初始化工作。*/
  ...

00000000004005f4 <main>:
  ...
  400626:       e8 95 fe ff ff          callq  4004c0 <strcpy@plt>
  ...
  40063f:       e8 9c fe ff ff          callq  4004e0 <printf@plt>
  ...
  /* 程序的实际 main 函数逻辑。*/
上述汇编代码片段揭示了执行流程:
_start处的指令在进行一些初步设置后,会将__libc_csu_init和main函数的地址作为参数,调用__libc_start_main。这个函数是C标准库(libc)的一部分,所有C/C++可执行程序都共享这段公共的初始化代码。__libc_start_main在完成一些系统级和进程级的初始化后,会首先调用__libc_csu_init。__libc_csu_init通常会进一步调用_init函数,_init中可能会包含对C++全局构造函数(通过__do_global_ctors_aux等)的调用,完成全局变量的初始化等操作。- 最终,
__libc_start_main将控制权交给我们程序中定义的main函数,开始执行核心业务逻辑。
根据这些信息,我们可以总结当通过bash运行一个程序时,Linux操作系统所执行的关键步骤:
- Shell(如bash)通过
fork系统调用创建一个子进程。 - 子进程随后调用
execve系统调用来加载并执行指定的ELF二进制程序。execve会将ELF文件的代码和数据加载到进程的虚拟内存空间中。 - 如果程序依赖动态链接库,动态链接器(通常是
/lib/ld-linux.so.2)会被调用,负责将所需的库文件映射到进程的地址空间。这些动态库的内存空间可以被多个进程共享。 - 内核从ELF文件头部读取
_start的地址,并将执行流的控制权转移到该地址。 _start处的代码进一步将执行流引导至libc库中的公共初始化代码__libc_start_main,进行程序运行前的各种必要初始化。- 在
__libc_start_main的执行过程中,它会调用_init函数来完成全局变量初始化等工作,随后才最终调用我们程序中定义的main函数,程序进入用户逻辑执行阶段。
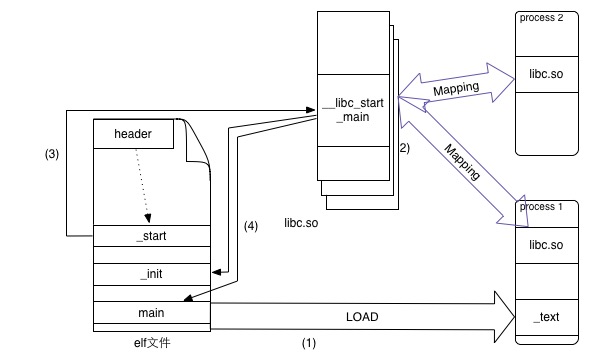
图1: 编译、链接、加载过程示意图
至此,我们完整地阐述了一个C语言程序从源代码到最终运行进程的全过程。
一个性能优化的小案例
理解编译器如何将源代码转换为二进制指令,能帮助我们预判代码执行效率,进而编写出更高效的代码。下面我们分析一个经典的面试题目,比较两段逻辑相似但结构不同的代码的优缺点。
#include <stdio.h>
#include <stdlib.h> // For malloc and free
#include <time.h>   // For rand() seed

// 辅助函数,生成随机数据
void generate_data(int* arr, int size) {
    for (int i = 0; i < size; ++i) {
        arr[i] = rand() % 100; // 0-99
    }
}

// 示例函数 A:条件判断在外层循环之外
long long calculate_sum_version_A(int mode, int count, int* data_array) {
    long long total_result = 0;
    if (mode == 0) {
        for (int i = 0; i < count; ++i) {
            total_result += data_array[i];
        }
    } else { // 假设 mode != 0 时执行另一种逻辑
        for (int i = 0; i < count; ++i) {
            total_result += (data_array[i] % 3 == 0) ? (-data_array[i]) : data_array[i];
        }
    }
    return total_result;
}

// 示例函数 B:条件判断在内层循环之内
long long calculate_sum_version_B(int mode, int count, int* data_array) {
    long long total_result = 0;
    for (int i = 0; i < count; ++i) {
        if (mode == 0) {
            total_result += data_array[i];
        } else { // 假设 mode != 0 时执行另一种逻辑
            total_result += (data_array[i] % 3 == 0) ? (-data_array[i]) : data_array[i];
        }
    }
    return total_result;
}

int main() {
    srand(time(NULL)); // 初始化随机数生成器
    int array_size = 1000000;
    int* my_data = (int*)malloc(array_size * sizeof(int));
    if (!my_data) {
        perror("Failed to allocate memory");
        return 1;
    }
    generate_data(my_data, array_size);

    int current_mode = 0; // 测试模式 0
    long long res_A = calculate_sum_version_A(current_mode, array_size, my_data);
    long long res_B = calculate_sum_version_B(current_mode, array_size, my_data);

    printf("Result A: %lld\n", res_A);
    printf("Result B: %lld\n", res_B);

    free(my_data);
    return 0;
}
从编程规范角度看,calculate_sum_version_B可能更简洁,因为它避免了代码冗余,并且可以将if/else分支中公共的部分提取到循环外部。然而,有经验的工程师会注意到calculate_sum_version_A的执行速度通常会比calculate_sum_version_B快。为什么会这样?我们通过观察编译器生成的汇编代码来分析:
使用gcc -O2 -S -fno-asynchronous-unwind-tables -fno-stack-protector example_perf.c命令生成汇编代码(并移除一些不影响分析的额外信息),我们会看到类似以下片段:
calculate_sum_version_A 函数汇编片段(部分):
; calculate_sum_version_A 函数入口
calculate_sum_version_A:
        ; ... 函数序言 ...
        cmp     edi, 0          ; 比较 mode 是否为 0
        jne     .L_mode_non_zero ; 如果不等于0,跳转到另一种逻辑
.L_mode_zero_branch:            ; mode == 0 的分支
        mov     eax, 0
        jmp     .L_loop_cond_zero ; 跳转到循环条件检查
.L_loop_body_zero:              ; mode == 0 循环体
        ; ... 循环内部计算 total_result += data_array[i] ...
        add     eax, 1
.L_loop_cond_zero:
        cmp     eax, esi        ; 比较循环变量 i 和 count
        jl      .L_loop_body_zero ; 如果 i < count,继续循环
        jmp     .L_exit_A       ; 循环结束,跳出函数
.L_mode_non_zero:               ; mode != 0 的分支
        mov     eax, 0
        jmp     .L_loop_cond_non_zero
.L_loop_body_non_zero:          ; mode != 0 循环体
        ; ... 循环内部计算 total_result += (data_array[i] % 3 == 0) ? (-data_array[i]) : data_array[i] ...
        add     eax, 1
.L_loop_cond_non_zero:
        cmp     eax, esi
        jl      .L_loop_body_non_zero
.L_exit_A:
        ; ... 函数尾声 ...
        ret
calculate_sum_version_B 函数汇编片段(部分):
; calculate_sum_version_B 函数入口
calculate_sum_version_B:
        ; ... 函数序言 ...
        mov     eax, 0
        jmp     .L_loop_cond_B  ; 跳转到循环条件检查
.L_loop_body_B:                 ; 循环体开始
        cmp     edi, 0          ; 比较 mode 是否为 0 (每次循环都执行)
        jne     .L_inner_non_zero ; 如果不等于0,跳转到另一种内部逻辑
.L_inner_mode_zero:             ; mode == 0 的内部逻辑
        ; ... 内部计算 total_result += data_array[i] ...
        jmp     .L_inner_exit   ; 跳转到内部逻辑结束
.L_inner_non_zero:              ; mode != 0 的内部逻辑
        ; ... 内部计算 total_result += (data_array[i] % 3 == 0) ? (-data_array[i]) : data_array[i] ...
.L_inner_exit:
        add     eax, 1
.L_loop_cond_B:
        cmp     eax, esi        ; 比较循环变量 i 和 count
        jl      .L_loop_body_B  ; 如果 i < count,继续循环
        ; ... 函数尾声 ...
        ret
通过对比汇编指令,我们可以发现:
-
分支判断频率: 在
calculate_sum_version_A中,条件判断(cmp edi, 0)只在函数入口处执行一次。一旦确定了mode的值,执行流就直接进入对应的循环体,并在整个循环过程中不再进行额外的mode判断。而在calculate_sum_version_B中,每次循环迭代都会执行一次mode的条件判断(cmp edi, 0)和可能的跳转。 -
分支预测与流水线: 现代CPU普遍采用指令流水线和分支预测技术来提高效率。如果CPU能准确预测下一个要执行的指令地址(例如在循环中,大部分情况下会执行同一分支),它就可以提前加载指令,减少等待时间。然而,当发生不可预测的条件跳转时(如
calculate_sum_version_B中每次循环都可能发生分支),CPU之前预测加载的指令可能失效,导致流水线清空(pipeline flush)和重新加载,浪费多个CPU周期。
因此,对于循环次数非常多的场景(如百万次),calculate_sum_version_B由于每次迭代都进行条件判断和潜在的跳转,会额外执行数百万条指令,并且更容易引发分支预测失败,导致性能下降。
总结来说,如果这段代码不是程序的性能瓶颈,calculate_sum_version_B因其更好的可读性和维护性而成为优先选择。但如果它处于性能敏感路径,calculate_sum_version_A通过减少分支判断和提高分支预测的准确性,能够提供更好的执行效率。这体现了在实际开发中,需要在代码规范、可维护性和执行性能之间进行权衡。
