深入解析 OpenGL 中的延迟着色技术与优化策略
渲染管线架构对比:从正向到延迟
在传统的图形渲染流程中,我们通常采用前向渲染(Forward Rendering)。这种模式的逻辑非常直观:针对场景中的每一个物体,循环遍历所有活跃光源,逐像素计算光照贡献。虽然开发成本较低且易于理解,但在处理高动态范围或复杂光源数量的场景时,效率会显著下降。因为对于每一个待渲染的像素,GPU 都需要重复执行完整的光照计算流程。更为严重的是,由于透明度过载或多层重叠导致的深度测试失败,大量片段着色器的运算结果会被丢弃,造成严重的性能浪费。
为了解决这一瓶颈,延迟着色(Deferred Shading)应运而生。它将几何处理与光照计算解耦,通过改变渲染顺序,使得无论场景中有多少个光源,光照计算的复杂度仅取决于屏幕分辨率上的像素数量,而非物体数量。这使得在屏幕上同时呈现数千个光源成为可能,而帧率依然保持在可接受范围内。
核心机制:双阶段处理
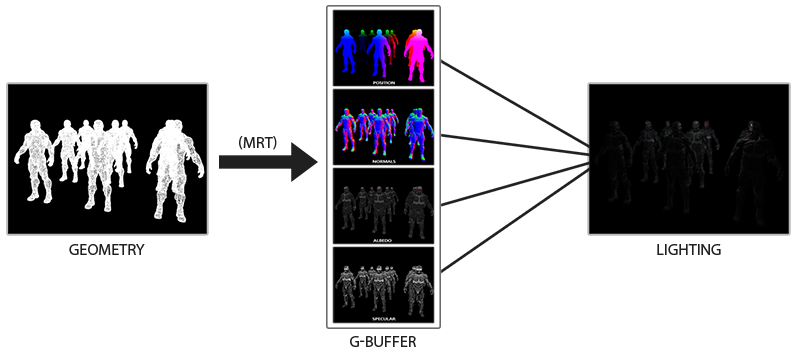
延迟渲染的核心思想在于"推迟"昂贵的光照计算。整个流程被拆分为两个独立的 Pass(处理阶段):
- 几何预处理阶段(Geometry Pass):在此阶段,我们不计算光照,而是专注于收集场景的几何信息。将每个物体的世界空间坐标、表面法线、漫反射颜色以及镜面强度等数据写入一组特殊的纹理中。这组纹理统称为 G-缓冲(G-buffer)。
- 光照重绘阶段(Lighting Pass):当 G-缓冲填充完毕后,我们将渲染目标切换回普通的颜色缓冲区。此时,程序不再依赖物体顶点/片段数据,而是直接从 G-缓冲纹理中采样当前像素的位置、法线和材质数据。随后在一个全屏 Quad 上运行高度优化的片段着色器,结合统一的光源参数进行最终的颜色合成。
这种方法的优势在于,经过深度测试过滤后,屏幕上的每一个可见像素仅会触发一次光照计算,避免了重复工作。下图展示了完整的延迟渲染流水线:
G-缓冲数据结构设计
在前向渲染中,光照所需的数据(位置、法线、反照率等)是逐对象传输的。而在延迟渲染中,这些数据必须被持久化存储在屏幕空间的纹理中。为了实现这一点,我们通常需要多个色彩附加点(Color Attachments)。利用多重渲染目标(MRT)技术,我们可以在单一 Draw Call 中并行写入不同的纹理通道。
G-缓冲通常包含以下纹理:
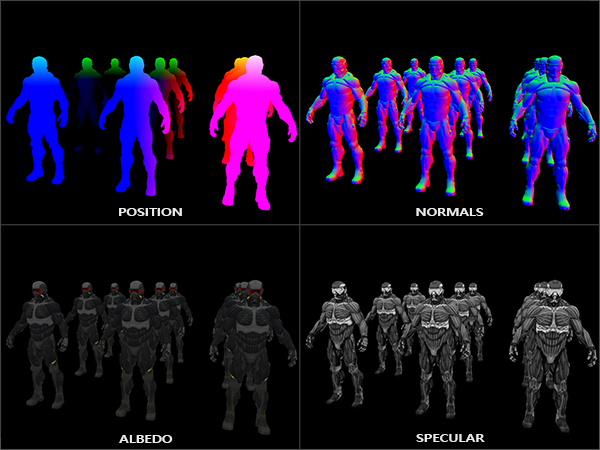
- 位置缓冲:存储摄像机的视图空间或世界空间坐标。
- 法线缓冲:存储归一化后的表面法线方向。
- 材质缓冲:混合存储漫反射颜色(Albedo)和高光强度(Specular),后者通常放在 Alpha 通道中。
初始化这一缓冲区的代码示例如下,注意这里使用了高精度浮点格式来存储空间向量:
GLuint deferredSceneFbo;
GLuint scenePosition, sceneNormal, materialData;

// 生成帧缓冲
glGenFramebuffers(1, &deferredSceneFbo);
glBindFramebuffer(GL_FRAMEBUFFER, deferredSceneFbo);

// 1. 位置纹理 (RGB16F)
glGenTextures(1, &scenePosition);
glBindTexture(GL_TEXTURE_2D, scenePosition);
glTexImage2D(GL_TEXTURE_2D, 0, GL_RGB16F, SCR_WIDTH, SCR_HEIGHT, 0, GL_RGB, GL_FLOAT, NULL);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MIN_FILTER, GL_NEAREST);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MAG_FILTER, GL_NEAREST);
glFramebufferTexture2D(GL_FRAMEBUFFER, GL_COLOR_ATTACHMENT0, GL_TEXTURE_2D, scenePosition, 0);

// 2. 法线纹理 (RGB16F)
glGenTextures(1, &sceneNormal);
glBindTexture(GL_TEXTURE_2D, sceneNormal);
glTexImage2D(GL_TEXTURE_2D, 0, GL_RGB16F, SCR_WIDTH, SCR_HEIGHT, 0, GL_RGB, GL_FLOAT, NULL);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MIN_FILTER, GL_NEAREST);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MAG_FILTER, GL_NEAREST);
glFramebufferTexture2D(GL_FRAMEBUFFER, GL_COLOR_ATTACHMENT1, GL_TEXTURE_2D, sceneNormal, 0);

// 3. 材质纹理 (RGBA32F,混合 Albedo 和 Specular)
glGenTextures(1, &materialData);
glBindTexture(GL_TEXTURE_2D, materialData);
glTexImage2D(GL_TEXTURE_2D, 0, GL_RGBA32F, SCR_WIDTH, SCR_HEIGHT, 0, GL_RGBA, GL_FLOAT, NULL);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MIN_FILTER, GL_NEAREST);
glTexParameteri(GL_TEXTURE_2D, GL_TEXTURE_MAG_FILTER, GL_NEAREST);
glFramebufferTexture2D(GL_FRAMEBUFFER, GL_COLOR_ATTACHMENT2, GL_TEXTURE_2D, materialData, 0);

// 指定绘图输出
GLenum attachments[3] = { GL_COLOR_ATTACHMENT0, GL_COLOR_ATTACHMENT1, GL_COLOR_ATTACHMENT2 };
glDrawBuffers(3, attachments);
为了填充这些数据,我们需要编写专门的几何渲染着色器。该着色器不关心光照,只负责导出上述需要的变量:
#version 330 core
layout (location = 0) out vec3 gPosition;
layout (location = 1) out vec3 gNormal;
layout (location = 2) out vec4 gMaterial;

in vec2 TexCoords;
in vec3 FragPos;
in vec3 Normal;

uniform sampler2D textureDiffuse;
uniform sampler2D textureSpecular;

void main()
{
    // 直接写入位置向量
    gPosition = FragPos;

    // 写入归一化法线
    gNormal = normalize(Normal);

    // 混合漫反射颜色和高光系数
    gMaterial.rgb = texture(textureDiffuse, TexCoords).rgb;
    gMaterial.a = texture(textureSpecular, TexCoords).r;
}
在渲染物体时,需确保所有变换都在世界坐标系下进行,这样后续计算光照时才能正确还原视角关系。填充完成后,G-缓冲的内容如下图所示(红色代表法线,不同色调代表位置变化):
光照计算阶段
一旦 G-缓冲就绪,真正的挑战来临。我们需要在这个阶段计算最终像素颜色。此时我们不再拥有原始几何体的顶点数据,所有的输入都来自对 G-缓冲的采样。这是一个全屏渲染过程,通常只需绘制一个覆盖整个视口的四边形。
主逻辑伪代码如下:
// 切换至默认帧缓冲(屏幕显示)
glBindFramebuffer(GL_FRAMEBUFFER, 0);
glClear(GL_COLOR_BUFFER_BIT);

// 绑定灯光着色器
applicationLightProgram.use();

// 绑定 G-缓冲纹理作为输入
glActiveTexture(GL_TEXTURE0); glBindTexture(GL_TEXTURE_2D, scenePosition);
glActiveTexture(GL_TEXTURE1); glBindTexture(GL_TEXTURE_2D, sceneNormal);
glActiveTexture(GL_TEXTURE2); glBindTexture(GL_TEXTURE_2D, materialData);

// 设置光源参数
sendAllLightsUniforms(applicationLightProgram);
glUniform3fv(..., viewPosition);

RenderQuad();
对应的片段着色器逻辑与前向渲染中的光照模型基本一致,主要区别在于数据获取方式。我们通过纹理坐标(UV)从 G-缓冲中检索出当前像素的世界坐标、法线和材质属性:
#version 330 core
out vec4 finalColor;
in vec2 TexCoords;

uniform sampler2D uGBufferPosition;
uniform sampler2D uGBufferNormal;
uniform sampler2D uGBufferMaterial;

struct LightSource {
    vec3 position;
    vec3 color;
    float constant;
    float linear;
    float quadratic;
};

const int MAX_LIGHTS = 32;
uniform LightSource lights[MAX_LIGHTS];
uniform vec3 viewPos;

void main()
{
    // 1. 从 G-Buffer 读取基础数据
    vec3 pPos = texture(uGBufferPosition, TexCoords).rgb;
    vec3 norm = texture(uGBufferNormal, TexCoords).rgb;
    vec4 matData = texture(uGBufferMaterial, TexCoords);

    vec3 albedo = matData.rgb;
    float specularScale = matData.a;

    vec3 result = vec3(0.0);
    vec3 viewDir = normalize(viewPos - pPos);

    // 环境光分量
    result += albedo * ambientStrength;

    // 逐个计算光源影响
    for(int i = 0; i < MAX_LIGHTS; ++i) {
        vec3 lightDir = normalize(lights[i].position - pPos);

        // ... 标准 Blinn-Phong 光照计算 ...
        // N . L

        // 添加漫反射和高光到累加器
        result += calculateDiffuseAndSpecular(norm, lightDir, viewDir,
                                              lights[i].color, specularScale);
    }

    finalColor = vec4(result, 1.0);
}
这种架构允许我们在同一着色器中轻松支持数百个光源,因为每个光源的计算开销是固定的,且不随场景物体积聚。
兼容性问题与混合方案
延迟渲染并非万能。它有两个明显的缺陷:不支持混合(Blending)和不支持传统 MSAA。原因在于 G-缓冲只记录了距离摄像机最近的一个像素的信息,丢失了其他透明或半透明物体的数据。此外,如果需要渲染发光效果(如光源本身可见),也无法直接在 G-缓冲中体现。
通常的解决方案是将渲染管线混合:大部分不透明物体走延迟管道,特殊效果(如光源球体、透明水坑)走前向管道。关键步骤是在绘制前向几何之前,将 G-缓冲中的深度缓冲拷贝到当前帧缓冲的深度缓冲区中,以确保深度测试正确:
// 将 G-Buffer 深度数据复制到默认 FrameBuffer
glBindFramebuffer(GL_READ_FRAMEBUFFER, deferredSceneFbo);
glBindFramebuffer(GL_DRAW_FRAMEBUFFER, 0);
glBlitFramebuffer(0, 0, SCR_WIDTH, SCR_HEIGHT,
                  0, 0, SCR_WIDTH, SCR_HEIGHT,
                  GL_DEPTH_BUFFER_BIT, GL_NEAREST);

// 关闭深度写入以避免污染 G-Buffer 深度图,然后渲染光立方体
glEnable(GL_BLEND);
RenderLightVolumes();
通过这种方式,我们可以叠加渲染那些无法放入 G-缓冲的特殊物体,而不会导致视觉穿帮。
大规模光源优化:光体积
即便有了延迟渲染,如果每一帧都对屏幕上的每个像素计算所有 32 个光源,计算量依然是巨大的。一个重要的优化思路是利用衰减(Attenuation)特性:**超出一定半径的光源对当前像素没有贡献**。这个有效距离即为光体积(Light Volume)半径。
我们可以通过求解衰减方程来确定光源的有效半径 $R$。假设亮度低于某个阈值 $L_{thresh}$(如 5/256)即视为无光,令衰减公式 $I(d) \le L_{thresh}$ 即可求出最大距离:
$$ \frac{I_{max}}{(Constant + Linear \cdot R + Quadratic \cdot R^2)} = \frac{5}{256} $$
由此推导出二次方程求根公式得到半径值:
float CalcMaxRadius(vec3 lightColor, float maxIntensity, float c, float l, float q) {
    float threshold = 5.0 / 256.0;
    float a = q;
    float b = l;
    float k = -(threshold * lightColor.r + c); // 简化示意

    // 实际逻辑应根据具体衰减方程求解
    return sqrt(b*b - 4*a*k) - b;
}
在实际应用中,更高效的优化是使用"光贴花"(Light Sprites)技术。即不为所有像素执行光照循环,而是为每个光源渲染一个与其半径匹配的球体贴花。只有贴花覆盖的像素才会被提交给片段着色器进行繁重的光照计算。这将复杂度从 $N_{obj} \times N_{lights}$ 降低到了 $N_{obj} + N_{lights}$。不过,这种方法的实现需要精细处理剔除(Culling)问题,防止用户穿越光源体积导致渲染遗漏,通常需借助模板缓冲(Stencil Buffer)来解决。
总结对比
延迟渲染在性能上限上远超传统前向渲染,特别适合现代游戏中大量动态光源的场景。其内存开销虽有所增加(G-缓冲占用 VRAM),但随着显存容量的提升,这已不再是主要障碍。尽管它在透明度处理和抗锯齿方面存在先天不足,需要通过混合渲染或多采样变通解决,但其在光照复杂度扩展性上的优势使其成为高端实时渲染的标准选择之一。
