数据结构底层机制:数组与链表深度解析
数据组织的基本范式
软件开发的核心在于逻辑运算与数据存储的结合。在计算机科学中,任何复杂的系统最终都可以归纳为两大要素:处理数据的步骤以及存储数据的方式。合理的存储结构能够显著提升算法的执行效率。
- 基础形态包括标量(数字、文本)与容器(序列、映射)。
- 高级抽象如树、图、堆栈等,本质上都是由最基础的线性结构演化而来。
连续内存:数组 (Array)
数组是最古老的数据模型之一。它在物理内存上占据了一段连续的地址空间。这种特性决定了它具有以下关键特征:
- 同质性:所有元素必须属于同一数据类型。
- 随机访问:由于地址连续,CPU 可以根据起始基址和偏移量直接计算目标元素的内存地址,无需遍历。
- 动态调整成本:当需要扩容时,通常需要申请新的更大内存块,并将旧数据复制过去,这会导致一定的开销。
非连续链接:链表 (Linked List)
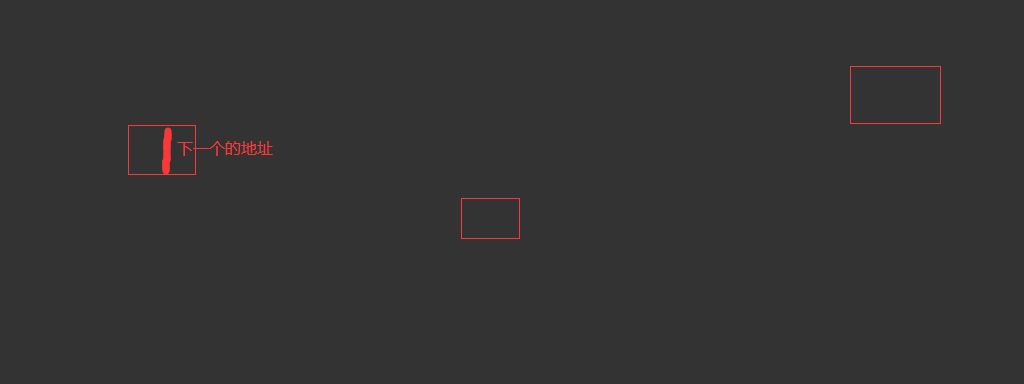
链表打破了内存连续性的限制。它由一系列称为"节点"的结构组成,每个节点包含两部分:
- 数据域:存储实际的有效信息。
- 指针域:记录下一个节点的内存地址。
这种设计使得内存分配变得灵活,节点可以分散在堆内存的任何位置,通过指针链串联起来。但这也牺牲了随机访问的能力,查找特定元素通常需要从头部开始逐个遍历。
操作复杂度对比分析
不同的底层存储方式决定了不同操作的执行代价。以下是针对常见操作的复杂度评估:
数组操作表现
虽然查询极其高效,但在中间插入或删除元素时,为了保持连续性,后续的所有元素都需要向前或向后迁移一位。
// 模拟数组移动逻辑 (JavaScript)
const arr = ['A', 'B', 'C'];
// 在索引 1 处插入 'X'
arr.splice(1, 0, 'X');
// 原 'B', 'C' 需依次向后位移,涉及多次内存写入
console.log(arr); // ['A', 'X', 'B', 'C']- 增/删:平均时间复杂度 $O(n)$,伴随空间换时间的移动操作。
- 查/取:$O(1)$,基于索引的直接寻址。
链表操作表现
一旦定位到目标节点的前驱节点,修改指针即可瞬间完成插入或删除,无需移动其他数据。
// 模拟单向链表插入节点 (Python 伪代码)
class Node:
    def __init__(self, val):
        self.val = val
        self.next = None

def insert_after(node, new_val):
    # 新节点指向原后继节点
    temp.next = node.next
    # 当前节点指向新节点
    node.next = new_node
# 耗时仅涉及两次指针赋值,O(1)- 增/删:定位前驱后,操作复杂度为 $O(1)$。
- 查/取:$O(n)$,必须从头顺藤摸瓜。
算法复杂度度量标准
在大 $O$ 表示法中,我们关注的是数据规模 $n$ 对运行时间的影响趋势:
- $O(1)$:常数级操作,无论数据多少,耗时恒定。
- $O(\log n)$:对数级,通常出现在二分查找中,每次排除一半搜索空间。
- $O(n)$:线性级,遍历一次整个数据集。
- $O(n^2)$:平方级,通常意味着嵌套的双重循环。
进阶结构与工程应用
在实际开发中,我们很少直接使用裸链表,而是使用其变体来优化特定场景:
- 双向链表:拥有指向上游和下游的双向指针,便于回退。
- 循环链表:尾部指针指向头部,形成闭环,常用于调度队列。
- 环检测:判断链表中是否存在闭合环路是常见的面试题场景。
主流语言与框架实现
- Java:
ArrayList封装了动态数组,而LinkedList基于双向链表。 - Python:内置列表 (List) 实际上是 C 语言实现的动态数组,具备高效的顺序存储优势。
哈希表冲突解决策略
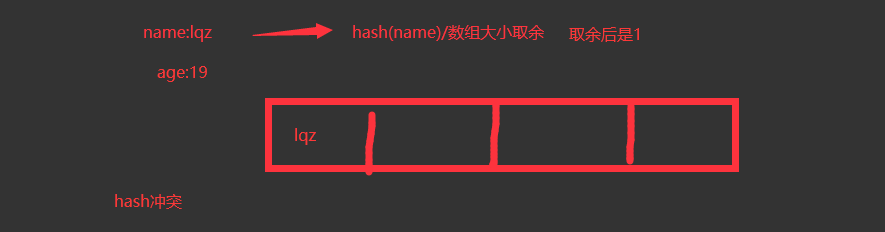
Redis 的 Hash 类型以及 Java 的 HashMap,底层均涉及将键值映射到数组下标的过程。当发生冲突时(Key 映射到同一地址),主要有以下几种方案:
- 开放定址法 (Open Addressing):若当前位置被占,则按特定规则(如线性探测、二次探测)寻找下一个空闲槽位。
- 链地址法 (Chaining):每个桶是一个链表(或红黑树),存入该位置的碰撞元素。Java 1.8+ 在此处做了平衡化升级以优化最坏情况下的性能。
- 再哈希法 (Rehashing):构建多个哈希函数,当第一个失效时使用第二个。
- 公共溢出区:建立独立区域专门存储碰撞数据。