多智能体架构设计:子智能体模式与监督者协调机制实战
多智能体系统的核心价值与适用边界
多智能体架构通过协同多个专业化模块来攻克复杂业务流。但需明确:复杂任务并非必然依赖多节点方案。单个智能体若配备动态工具集与精心设计的提示词,往往也能胜任同等规模的工作。开发者倾向引入多智能体方案,通常出于三大核心诉求:
- 上下文隔离与窗口优化:在提供领域专业知识的同时,避免主模型的上下文窗口被冗余信息淹没。由于上下文长度与推理延迟存在物理限制,系统必须采用选择性注入策略,仅呈现当前步骤所需的数据。
- 模块化协同开发:允许不同工程团队独立构建、测试与维护特定能力,最终通过明确定义的接口组合成高内聚、低耦合的大型系统。
- 并发加速:为独立子任务生成专用执行器并并行调度,显著缩短端到端响应时间。
当单一模型面临工具过载导致决策劣化、任务具备强领域属性(需长提示与专用API)、或业务流程存在严格序列约束时,多智能体架构的工程价值才会真正凸显。
典型适用场景
- 高度异构任务处理:系统需同时涵盖自然语言解析、关系型数据库检索、视觉特征提取与安全合规审查。可为每项能力分配独立节点(如规划器、执行器、审核器、护栏节点)。
- 流水线式分工:例如学术内容生成链路,节点A负责文献抓取,节点B设计实验方案,节点C负责行文润色,节点D执行事实校验。单一模型难以在所有环节保持专家级水准。
- 对抗与博弈模拟:市场交易推演、辩论系统或红蓝攻防演练,依赖多个目标函数不同的节点进行动态交互。
- 可靠性与安全审计:引入审查节点(Critic)对主节点输出进行二次验证,实现"执行-审计"职责分离,有效压制幻觉与越权操作。
- 高并发子任务:多数据源并行查询或批量处理,多节点架构天然契合并发调度模型。
- 高可维护性诉求:团队期望独立迭代功能模块,规避"大模型单体应用"带来的代码耦合与回归测试难题。
主流编排模式概览
构建多智能体系统时,可根据业务特征选择以下核心编排范式:
| 编排模式 | 运行机制 |
|---|---|
| 子智能体(Sub-Agent) | 中央节点将下游节点封装为工具进行统一调度。所有路由决策均由中央节点掌控,动态决定触发时机与参数传递。 |
| 交接(Handoff) | 控制权随状态变量动态流转。工具调用更新全局状态,触发路由切换或提示词重载,实现节点间的平滑过渡。 |
| 技能(Skills) | 按需加载专业提示与知识库。单节点保持主控权,仅在特定阶段动态挂载技能上下文,避免常驻内存膨胀。 |
| 路由器(Router) | 前置分类层对输入意图进行识别,并将其分发至一个或多个专家节点。最终结果经聚合层统一输出。 |
| 自定义工作流 | 基于图计算引擎(如LangGraph)构建确定性逻辑与智能体行为混合的执行流。可将其他模式作为图节点嵌入。 |
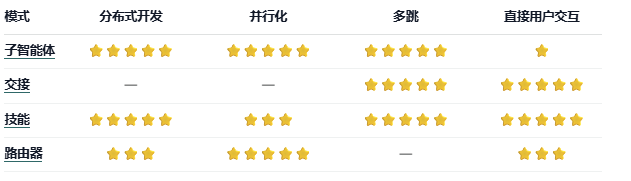
在选型时需评估:团队是否支持分布式维护?子任务能否并行?是否需多跳串联调用?下游节点是否需直接面向终端用户?实际工程中常采用混合架构,例如主节点调用工具触发自定义工作流,或动态挂载技能上下文。
聚焦监督者架构:子智能体模式深度解析
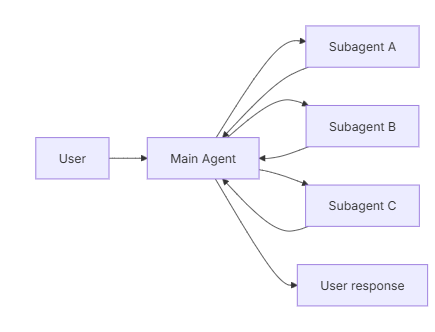
在子智能体范式中,中央主控节点(通常称为监督者或Orchestrator)通过将下游专家封装为可调用的工具来实现协调。监督者负责路由决策、参数构造与结果聚合。下游节点设计为无状态实例,不保留历史交互记忆,所有对话上下文由监督者统一托管。该设计实现了严格的上下文隔离:每次子节点调用均在干净的窗口中执行,彻底阻断主对话历史的膨胀。
核心机制与特征
- 集中式路由:所有请求分发与结果回收均经过监督者。
- 间接用户交互:子节点仅向监督者返回数据,不直接面向终端用户(可通过中断机制特殊配置)。
- 工具化抽象:子节点能力对监督者完全透明,表现为标准工具接口。
- 并行调度能力:监督者可在单轮推理中并发触发多个独立子节点。
与单纯的路由器不同,监督者维护完整的多轮对话状态,能够基于历史上下文动态调整调度策略。该模式适用于多领域交叉(如日程、通信、CRM、数据查询)、需集中管控工作流且子节点无需直接对话的场景。若工具数量极少,单节点方案通常更具性价比。
执行策略:同步阻塞与异步后台
子节点的执行时机取决于监督者是否依赖其输出以推进后续逻辑:
| 执行模式 | 监督者行为 | 适用场景 | 工程权衡 |
|---|---|---|---|
| 同步(默认) | 阻塞等待子节点返回 | 强依赖链、顺序执行任务 | 实现简单,但会冻结对话流 |
| 异步 | 下发任务后继续响应 | 独立耗时任务、用户无需等待 | 体验流畅,但需配套任务追踪机制 |
同步执行
默认采用同步调用。当监督者的下一步决策强依赖子节点输出,或任务存在严格先后顺序(如:拉取数据 → 清洗分析 → 生成报告)时,同步模式最为稳妥。子节点异常将直接中断主流程,便于错误收敛。代价是长耗时任务会导致用户端感知卡顿。
异步执行
当子任务与主对话流解耦时,应切换至异步模式。监督者下发后台作业后保持响应能力,通常需配合三件套工具:
- 任务下发:启动后台进程,返回唯一Job ID。
- 状态轮询:查询作业生命周期(Pending/Running/Completed/Failed)。
- 结果提取:拉取已完成作业的输出数据。
应用层需在作业完成时主动通知用户(如推送消息),用户点击后可触发类似"检查 job_882 状态并汇总"的指令,重新接入主流程。
工具暴露方案:独立封装与统一路由
将子节点接入监督者主要有两种工程路径:
| 封装策略 | 适用场景 | 优缺点 |
|---|---|---|
| 独立工具映射 | 需精细控制各节点输入输出格式 | 配置繁琐,但定制化程度极高 |
| 统一调度器 | 节点众多、跨团队协作、约定优于配置 | 接入极简,牺牲部分节点级定制能力 |
独立工具映射
为每个专家节点单独包装工具函数。监督者根据工具描述匹配意图,触发调用并接收结果。
from agent_framework import Tool, AgentFactory

# 实例化领域专家
domain_expert = AgentFactory.build(llm=base_model, toolset=[])

@Tool(name="deep_search", desc="执行深度资料调研并输出结论")
def trigger_expert(query_text: str) -> str:
    response = domain_expert.run(input_data={"history": [{"role": "user", "text": query_text}]})
    return response.history[-1].text

# 组装主控节点
controller = AgentFactory.build(llm=base_model, toolset=[trigger_expert])
output = controller.run(input_data={"history": [{"role": "user", "text": "调研量子计算突破并提炼核心观点"}]})
for item in output.history:
    item.display()
统一调度器(参数化路由)
现代多智能体框架常采用单入口动态路由方案。核心思想是废弃预定义的专用工具,转而提供通用的 dispatch_task(worker_id, instruction) 接口。监督者传入自然语言指令与目标节点标识,框架临时实例化或复用对应专家,执行后返回最终响应。所有子节点遵循统一契约:接收单条人类消息,返回单条AI消息。
from agent_framework import Tool, AgentFactory

research_worker = AgentFactory.build(llm=base_model, prompt="专注数据检索与事实核对...")
draft_worker = AgentFactory.build(llm=base_model, prompt="专注文案撰写与排版优化...")

WORKER_REGISTRY = {"research": research_worker, "draft": draft_worker}

@Tool
def dispatch_task(worker_id: str, instruction: str) -> str:
    """动态路由至指定专家节点。支持ID: research, draft"""
    target = WORKER_REGISTRY.get(worker_id)
    if not target:
        return f"未注册节点: {worker_id}"
    res = target.run(input_data={"history": [{"role": "user", "text": instruction}]})
    return res.history[-1].text

orchestrator = AgentFactory.build(
    llm=base_model,
    toolset=[dispatch_task],
    prompt="作为总控中心,请根据需求将指令分发至 research 或 draft 节点。"
)
该方案极大降低了跨团队集成成本。子节点甚至可与主节点能力重叠,此时调用的核心目的在于上下文隔离:在独立窗口中执行复杂多步推理,仅将精简摘要回传主线程,保持主对话轻量化。
上下文工程:精准控制信息流转
监督者与子节点间的数据交换需精细设计,主要涵盖三个维度:
- 路由规则:工具名称与描述是监督者决策的唯一依据。命名需具备动作导向性(如
audit_contract),描述需明确边界条件与适用场景。 - 输入构造:静态提示词往往不足以支撑复杂任务。可通过运行时上下文注入完整对话历史、前置任务结果或用户元数据。
- 输出过滤:强制子节点在最终消息中携带关键结论。常见陷阱是子节点执行了工具调用但未将结果写入最终回复,导致监督者接收到空内容。可通过代码层拦截或提示词强约束解决。
from agent_framework import Tool, RuntimeContext, StatePayload

class ExtendedState(StatePayload):
    user_profile: str

@Tool(name="specialized_task", desc="处理特定领域请求")
def run_with_context(query: str, ctx: RuntimeContext[None, ExtendedState]) -> str:
    # 动态拼接主线程状态与当前指令
    enriched_input = f"[用户背景: {ctx.state.user_profile}]\n任务: {query}"
    res = specialized_worker.run(input_data={"history": [{"role": "user", "text": enriched_input}]})
    return res.history[-1].text
若需向监督者回传结构化状态而非纯文本,可借助指令对象(Command)更新全局状态机:
from typing import Annotated
from agent_framework import Tool, Command, ToolResponse

@Tool(name="contextual_task", desc="带状态回传的专家调用")
def run_and_update(query: str, call_id: Annotated[str, "ToolCallID"]) -> Command:
    res = specialized_worker.run(input_data={"history": [{"role": "user", "text": query}]})
    return Command(
        state_patch={"custom_flag": res.metadata.get("custom_flag")},
        responses=[ToolResponse(content=res.history[-1].text, call_id=call_id)]
    )
实战演练:构建双层协调的个人事务助理
监督者模式在跨领域任务中表现优异。以下示例构建一个个人助理系统,由中央节点协调"日程管理"与"邮件通信"两位专家,并演示完整的数据流控制。
底层能力定义
首先定义强类型工具。实际生产环境中应替换为真实API调用,此处使用存根演示契约设计。
from agent_framework import Tool

@Tool
def book_meeting(title: str, start_iso: str, end_iso: str, guests: list[str], venue: str = "") -> str:
    """创建日程。时间需符合ISO8601标准。"""
    return f"日程已锁定: {title} | {start_iso} 至 {end_iso} | 参与方: {len(guests)}"

@Tool
def dispatch_mail(recipients: list[str], topic: str, content: str, copy_to: list[str] = None) -> str:
    """发送邮件通信。"""
    return f"信件已投递至 {', '.join(recipients)} | 主题: {topic}"

@Tool
def query_free_slots(participants: list[str], target_date: str, duration_mins: int) -> list[str]:
    """检索空闲时段。"""
    return ["09:30", "13:00", "15:30"]
专家节点实例化
为每个领域创建专注型子节点,配备专属提示词与工具集。
SCHEDULER_PROMPT = """你是日程规划专家。负责将口语化时间转换为ISO格式。
必要时调用 query_free_slots 确认档期,最终通过 book_meeting 落盘。
回复必须包含明确的日程确认信息。"""
calendar_node = AgentFactory.build(base_model, toolset=[book_meeting, query_free_slots], prompt=SCHEDULER_PROMPT)

MAILER_PROMPT = """你是通信助理。负责提炼收件人、拟定专业标题与正文。
完成后调用 dispatch_mail 发送。最终回复需附带发送凭证。"""
mail_node = AgentFactory.build(base_model, toolset=[dispatch_mail], prompt=MAILER_PROMPT)
工具化包装与总控节点组装
将专家节点封装为高层语义工具,供监督者调用。此举隐藏了底层API细节,使监督者仅需关注业务意图路由。
@Tool
def handle_scheduling(nl_request: str) -> str:
    """自然语言日程编排。自动处理时间解析与冲突检测。"""
    out = calendar_node.run({"history": [{"role": "user", "text": nl_request}]})
    return out.history[-1].text

@Tool
def handle_mailing(nl_request: str) -> str:
    """自然语言邮件代发。自动补全收件人与正文结构。"""
    out = mail_node.run({"history": [{"role": "user", "text": nl_request}]})
    return out.history[-1].text

ORCHESTRATOR_PROMPT = """你是个人事务总管。具备日程规划与邮件通信能力。
请拆解用户意图,按需串行或并行调用 handle_scheduling 与 handle_mailing。
整合各节点反馈后输出统一答复。"""
supervisor = AgentFactory.build(base_model, toolset=[handle_scheduling, handle_mailing], prompt=ORCHESTRATOR_PROMPT)
当用户输入复合指令(如"下周二下午2点与设计组开会,并发邮件提醒他们审查原型图")时,监督者会识别出双重意图,并行或串行触发对应工具。各子节点在隔离环境中完成解析、API调用与结果格式化,最终由监督者聚合为连贯响应。
高阶技巧:上下文注入与输出过滤
默认情况下,子节点仅接收工具参数。若需消除指代歧义(如"安排在明天同一时间"),需注入主线程历史:
@Tool
def handle_scheduling_ctx(nl_request: str, rt: RuntimeContext) -> str:
    """带历史上下文的日程处理"""
    last_user_msg = next((m for m in rt.state["history"] if m.role == "user"), None)
    context_prompt = f"原始诉求:\n{last_user_msg.text}\n\n当前子任务:\n{nl_request}"
    out = calendar_node.run({"history": [{"role": "user", "text": context_prompt}]})
    return out.history[-1].text
同时,可通过代码层拦截子节点输出,仅提取确认文本或结构化JSON回传监督者,避免中间推理步骤污染主对话窗口。监督者架构通过清晰的职责分层实现系统解耦:底层处理刚性API协议,中层负责自然语言到结构化数据的转换,顶层专注意图识别与结果合成。该模式适用于领域边界清晰、各域逻辑复杂且需集中管控工作流的场景。若子节点需频繁与用户直接交互,或节点间需点对点网状通信,则应评估交接模式或图工作流方案。
