Codex CLI 高级配置:模型上下文协议 (MCP) 集成与核心配置解析
Codex CLI 作为一款强大的 AI 辅助编程工具,通过支持模型上下文协议 (Model Context Protocol, MCP) 极大地扩展了其功能边界。不同于 Claude 或 Cursor 等常见编辑器使用 JSON 格式配置 MCP 服务,Codex CLI 采用 TOML 文件格式进行管理。本文旨在全面解析 Codex CLI 中 MCP 服务的配置、验证与实际调用流程,并深入剖析其核心配置文件 ~/.codex/config.toml 的各项关键设置,助力开发者高效实现自定义工具集成。
一、配置 MCP 服务扩展
在 Codex CLI 中集成 MCP 服务,需要编辑用户目录下的 ~/.codex/config.toml 文件,并在其中定义一个 [mcp_servers] 部分。以下是一个配置多个 MCP 服务的示例:
# 定义一个名为 "context_extractor" 的 MCP 服务器
[mcp_servers.context_extractor]
command = "npx"
args = ["-y", "@upstash/context7-mcp"]
env = { "API_KEY" = "your_context7_api_key_here" } # 示例环境变量,可根据需要配置

# 定义一个用于浏览器自动化的 MCP 服务器
[mcp_servers.browser_automation]
command = "npx"
args = ["-y", "@modelcontextprotocol/server-puppeteer"]
env = { "PROXY_URL" = "http://localhost:8080" } # 示例代理设置
在这个示例中,我们配置了两个 MCP 服务器:context_extractor 用于文本上下文提取,以及 browser_automation 用于基于 Puppeteer 的浏览器操作。通过 command 和 args 指定服务器启动方式,env 则允许传递环境变量。
二、MCP 服务连接验证
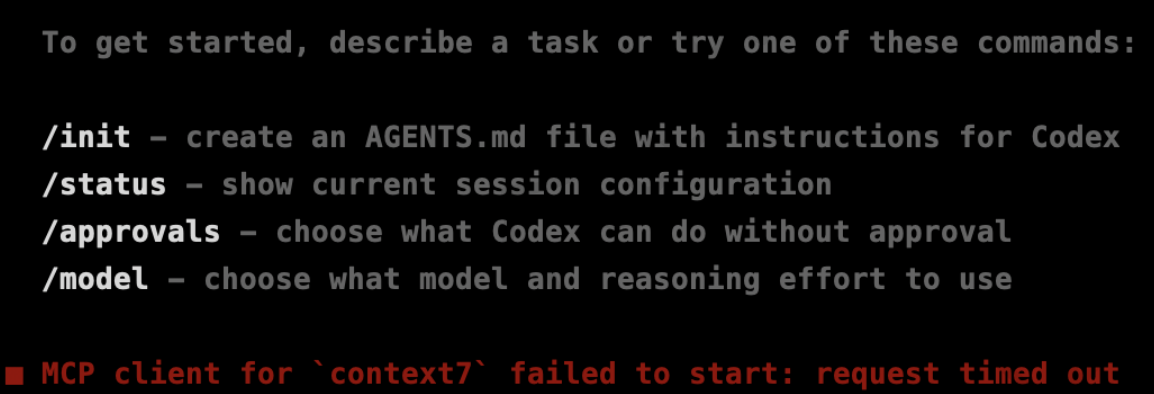
当前版本的 Codex CLI 尚未提供独立的命令来显式验证 MCP 服务器的连接状态。然而,在 Codex 启动时,如果配置的 MCP 服务未能成功连接,系统会立即报错。这提供了一个直接的反馈机制来排查配置问题。
例如,若不慎将 MCP 服务器的包名配置错误,Codex 启动时会显示如下错误信息,指示无法找到或启动对应的服务:
三、实际调用 MCP 工具
一旦 MCP 服务配置成功,Codex CLI 便可以在执行任务时自动识别并调用这些外部工具。以下是一个调用名为 context_extractor 的 MCP 服务的示例:
如图所示,控制台成功显示了 context_extractor 工具被调用,并基于其功能输出了相应的代码或信息。
四、Codex 核心配置文件 config.toml 详解
~/.codex/config.toml 是 Codex CLI 的核心配置文件,包含了全局设置、模型提供商定义以及个性化配置模板。深入理解这些配置项,能帮助用户更灵活地定制 Codex 的行为。
全局设置
这些选项位于配置文件的开头,影响 Codex 的整体行为和默认设置:
# 指定默认使用的 AI 模型,例如 "claude-3-opus-20240229" 或 "gpt-4o"
model = "claude-3-opus-20240229"
# 设置模型推理的详尽程度,可选值包括 "low", "medium", "high"
model_reasoning_effort = "high"

# 设定默认的模型服务提供商
model_provider = "anthropic" # 例如,将默认提供商设为 Anthropic

# 配置代码执行的沙盒安全策略
# 可选值: read-only, workspace-write, danger-full-access, elevated
sandbox_mode = "workspace-write"

# 定义操作审批策略,决定何时需要用户确认
# 可选值: on-failure (失败时审批), on-request (请求时审批), untrusted (不信任操作审批), never (从不审批)
approval_policy = "on-failure"
模型提供商定义
此部分允许您配置不同的 AI 模型服务提供商的详细信息,包括 API 端点、认证方式等。这些定义可以在后续的 Profile 中被引用。
# 定义一个 OpenRouter 模型服务提供商
[model_providers.openrouter_service]
name = "OpenRouter AI Gateway"
base_url = "https://openrouter.ai/api/v1"
env_key = "OPENROUTER_API_KEY" # 存储API密钥的环境变量名称
wire_api = "chat"
query_params = {} # 可选,用于API调用的额外查询参数

# 定义一个 OpenAI 模型服务提供商
[model_providers.openai_platform]
name = "OpenAI Chat Completions API"
base_url = "https://api.openai.com/v1"
env_key = "OPENAI_API_KEY" # 存储API密钥的环境变量
wire_api = "chat"

# 额外示例:一个假想的本地模型服务(如通过 Ollama 部署)
[model_providers.local_llm_server]
name = "Local LLM via OLLAMA"
base_url = "http://localhost:11434/api"
env_key = "OLLAMA_API_KEY" # 如果本地服务需要API密钥,可在此配置
wire_api = "chat"
配置模板(Profiles)
Profile 允许您预定义一组模型和 AI 提供商的组合配置,方便在不同场景下快速切换。这避免了重复配置相同的参数。
# 定义一个名为 "dev_strict" 的开发环境配置模板
[profiles.dev_strict]
model = "gpt-4o" # 使用最新的GPT-4o模型
model_provider = "openai_platform" # 关联之前定义的OpenAI提供商
approval_policy = "on-request" # 每次操作都需要用户审批,确保开发安全
model_reasoning_effort = "medium"
model_reasoning_summary = "concise" # 总结更简洁,适合快速浏览

# 定义一个名为 "fast_experiment" 的快速实验配置模板
[profiles.fast_experiment]
model = "meta-llama/llama-3-8b-instruct" # 使用Llama 3模型进行实验
model_provider = "openrouter_service" # 关联OpenRouter提供商,便于访问多种模型
approval_policy = "never" # 无需审批,适合快速迭代和测试
配置完成后,您可以通过 Codex 的命令行参数来选择使用特定的 Profile,例如 codex -p <profile_name>。此外,也可以使用 codex -m <model_name> 直接指定模型,此时会沿用默认的模型提供商。
