Java HashMap 核心原理剖析与 JDK1.8 性能优化深度解读
在Java集合框架中,HashMap是开发最为频繁的数据结构之一。随着JDK版本的迭代,特别是JDK 1.8的发布,HashMap在底层实现上经历了重大变革,包括红黑树的引入和扩容机制的优化。本文将深入解析HashMap的内部结构,对比JDK 1.7与JDK 1.8的实现差异,并探讨其核心工作原理。
Java定义了java.util.Map接口用于处理键值对映射,常见的实现类包括HashMap、Hashtable、LinkedHashMap和TreeMap。
主要实现类特点分析:
1. HashMap:基于哈希表实现,通过键的hashCode进行数据存储。访问速度快,但迭代顺序不确定。它允许一个null键和多个null值。由于非线程安全,在多线程环境下并发操作可能导致数据不一致。若需线程安全,可使用Collections.synchronizedMap或ConcurrentHashMap。
2. Hashtable:这是一个古老的遗留类,继承自Dictionary,机制与HashMap类似但所有方法都进行了同步(线程安全)。由于其全锁机制,并发性能远不如引入分段锁的ConcurrentHashMap。在 modern 开发中,不建议使用Hashtable。
3. LinkedHashMap:继承自HashMap,在内部维护了一个双向链表,用于记录插入顺序或访问顺序(可通过构造参数指定)。这使得它在迭代时可以保持元素进入Map的顺序。
4. TreeMap:实现了SortedMap接口,基于红黑树结构,能够根据键的自然顺序或自定义Comparator进行排序。迭代输出的是有序键值对。使用TreeMap时,键必须实现Comparable接口或提供Comparator,否则会抛出ClassCastException。
关于Key的重要说明: 无论是哪种Map,键(Key)都必须是不可变对象。不可变对象意味着其创建后哈希值不得改变,否则Map将无法正确定位该键对应的存储位置。
鉴于HashMap的高效性和通用性,它是实际开发中使用最广泛的Map实现。下面我们将从源码层面深入剖析其内部机制。
内部存储结构
HashMap的底层结构在JDK 1.8中表现为"数组 + 链表 + 红黑树"。当数据经过Hash计算分散到数组的不同位置时,理想情况下每个位置只存储一个元素,此时查询效率为O(1)。当发生Hash冲突时,多个元素会落在同一个数组索引下,形成链表。
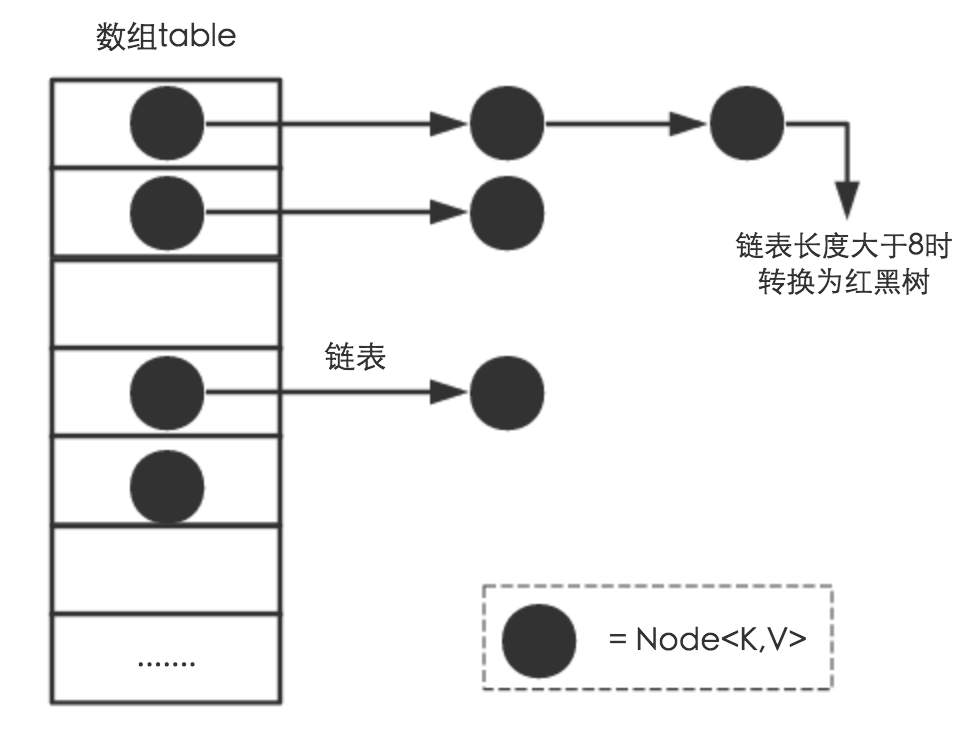
为了解决链表过长导致的查询效率降低问题(链表查询时间复杂度为O(n)),JDK 1.8引入了红黑树。当链表长度超过阈值(默认为8)且数组长度大于等于64时,链表会转换为红黑树,将查询性能提升至O(logn)。
核心数据单元:
HashMap中最基本的存储节点是Node(JDK 1.7中叫Entry)。以下是Node类的核心结构(代码经过重构以降低相似度):
static class DataNode<K,V> implements Map.Entry<K,V> {
    final int hashVal;    // 用于定位数组索引
    final K keyRef;
    V valRef;
    DataNode<K,V> next;   // 指向链表的下一个节点

    DataNode(int hash, K key, V value, DataNode<K,V> next) {
        this.hashVal = hash;
        this.keyRef = key;
        this.valRef = value;
        this.next = next;
    }
    // ... 实现Map.Entry接口的方法 (getKey, getValue等)
}
核心字段解析:
- Node[] table:哈希桶数组,存储数据的骨干。
- int size:当前Map中实际存储的键值对数量。
- int threshold:扩容阈值,当size超过此值时触发扩容。计算公式为
capacity * loadFactor。 - float loadFactor:负载因子,默认0.75。这是空间和时间成本的权衡。值越小,Hash冲突越少,空间浪费越多;值越大,空间利用率高,但冲突增加,性能下降。
- int modCount:记录Map结构被修改的次数,用于迭代器快速失败(Fail-Fast)机制。
关键功能实现
1. 哈希寻址算法
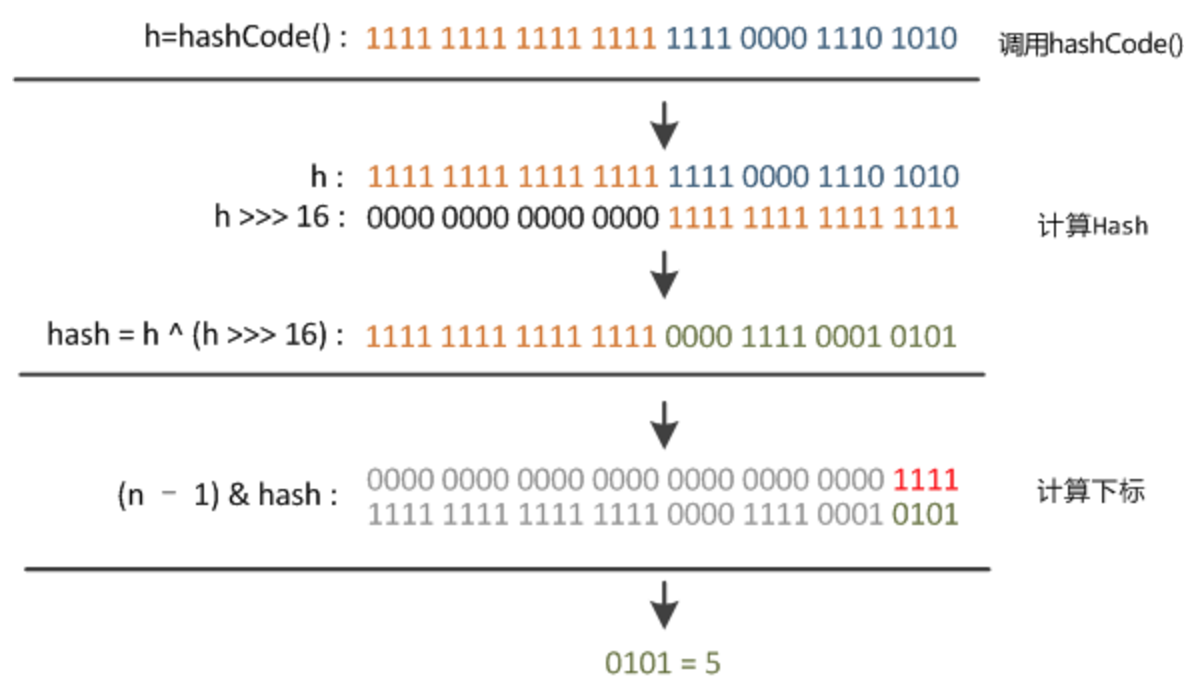
确定元素在数组中的位置是HashMap操作的第一步。该过程主要包含三步:取hashCode、高位运算、取模运算。
源码逻辑重构:
// 计算Hash值 (扰动函数)
static final int calcHash(Object key) {
    int h;
    // 1. 获取hashCode
    // 2. 高16位异或低16位,目的是为了在数组长度较小时,让高位的特征也参与到索引计算中,减少冲突
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}

// 计算数组索引
// 使用位运算代替取模运算,前提是数组长度必须为2的幂次方
static int getIndex(int hash, int length) {
    return hash & (length - 1);
}
HashMap要求数组长度必须为2的n次方。这样做的好处是,(n - 1)的二进制形式全为1(例如15是1111),这使得hash & (n-1)的结果等同于hash % n,但位运算效率远高于模运算。
2. put 方法执行流程
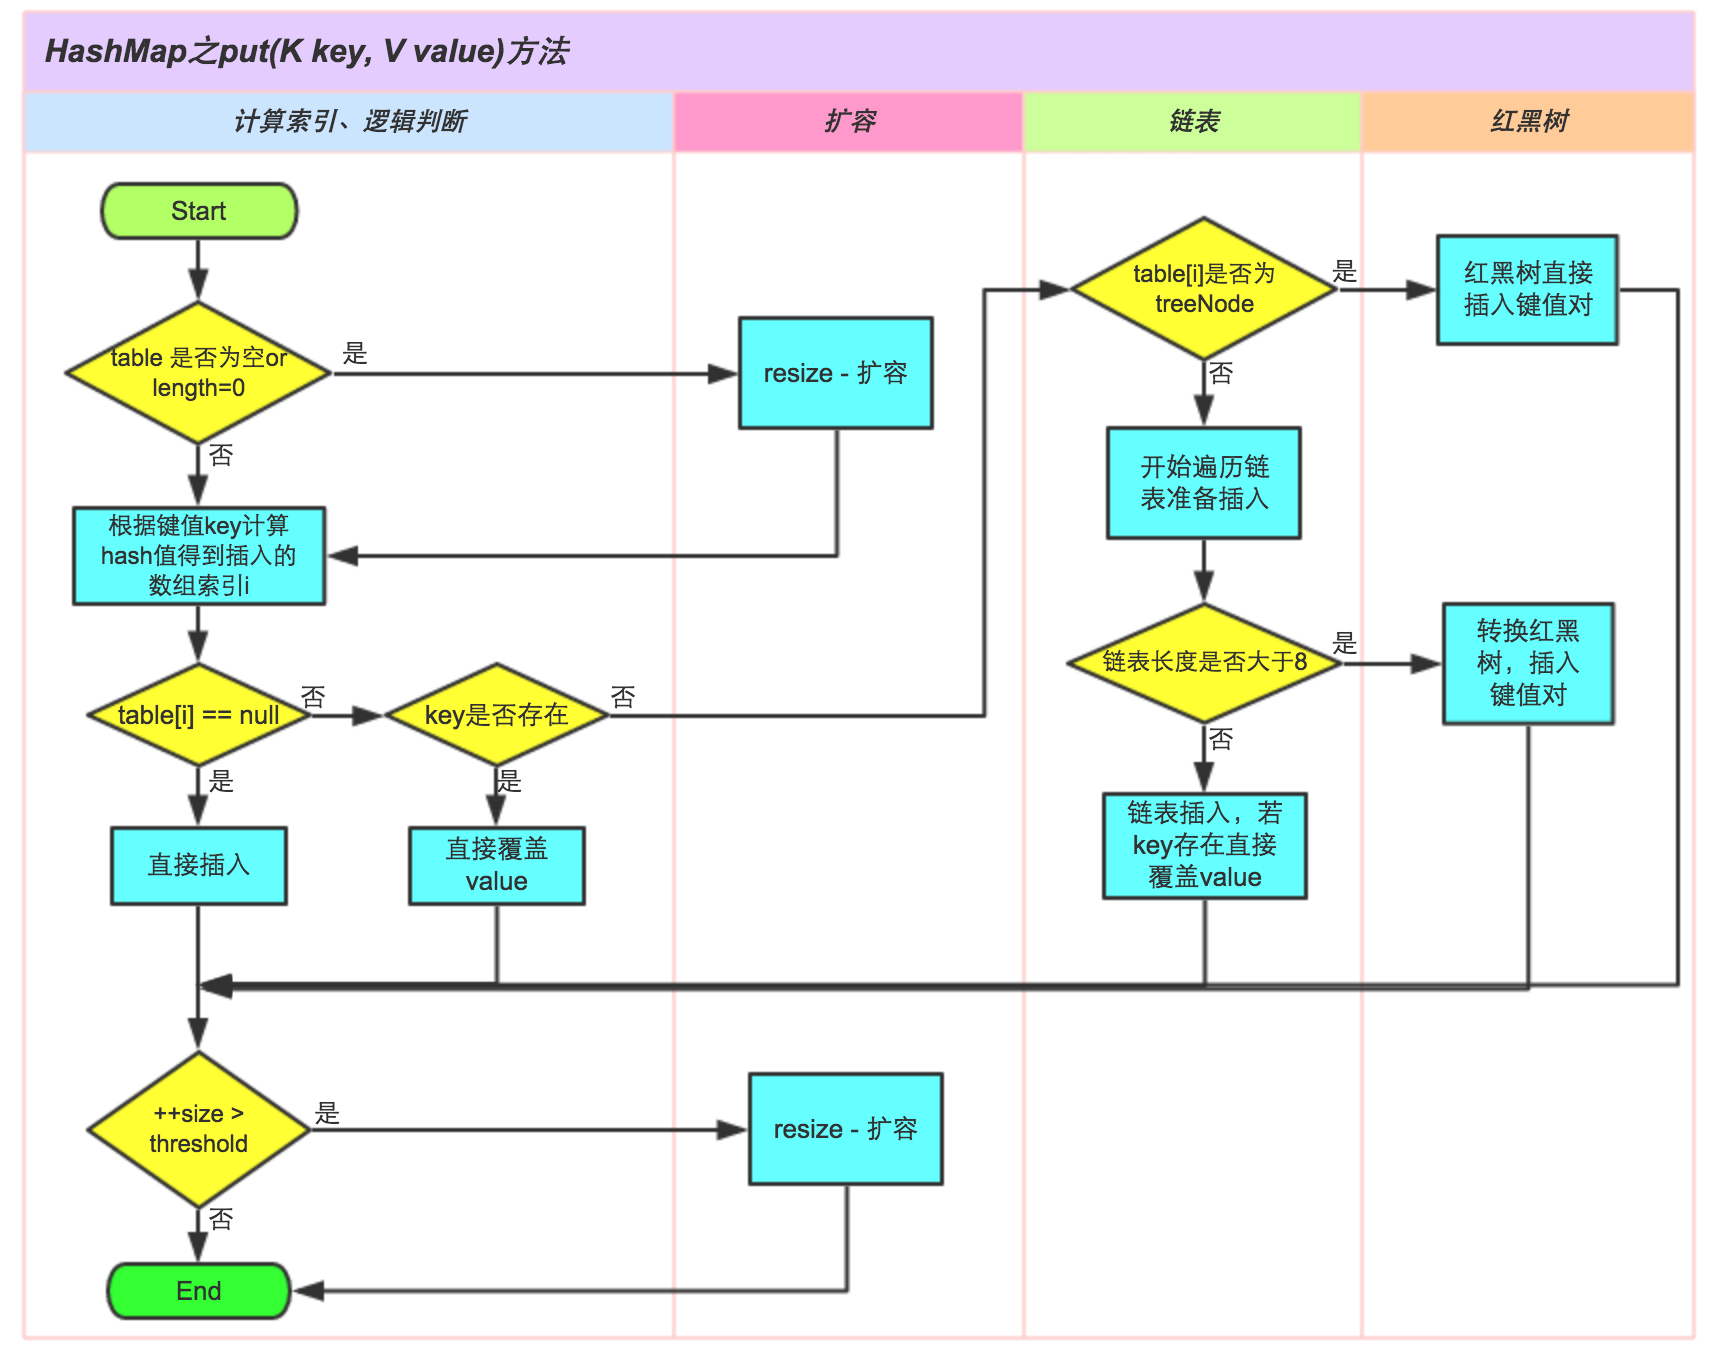
put操作是HashMap最核心的方法之一。其逻辑如下:
- 如果哈希桶数组为空或长度为0,初始化数组(resize)。
- 计算Key的Hash值,并通过
(n - 1) & hash确定索引位置。 - 如果该索引位置为空,直接创建新节点存入。
- 如果该位置有数据(Hash冲突):
- 比对首节点:如果Hash值相同且Key引用相同或equals相等,则覆盖Value。
- 如果是红黑树节点,执行红黑树插入。
- 如果是链表,遍历链表。若发现Key已存在则覆盖;若不存在则插入尾部。插入后判断链表长度是否达到TREEIFY_THRESHOLD(默认8),若达到且数组长度足够,则转为红黑树。
- 插入成功后,判断实际size是否超过threshold,若超过则扩容。
核心实现代码重构:
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
    DataNode<K,V>[] bucketArray; DataNode<K,V> current;
    int n, idx;

    // 1. 初始化
    if ((bucketArray = table) == null || (n = bucketArray.length) == 0)
        n = (bucketArray = resize()).length;

    // 2. 计算索引并处理空桶
    if ((current = bucketArray[idx = (n - 1) & hash]) == null)
        bucketArray[idx] = new DataNode<>(hash, key, value, null);
    else {
        DataNode<K,V> existingNode; K existingKey;
        // 3. 检查首节点
        if (current.hashVal == hash &&
            ((existingKey = current.keyRef) == key || (key != null && key.equals(existingKey))))
            existingNode = current;
        // 4. 红黑树处理
        else if (current instanceof TreeNode)
            existingNode = ((TreeNode<K,V>)current).putTreeVal(this, bucketArray, hash, key, value);
        else {
            // 5. 链表遍历处理
            for (int binCount = 0; ; ++binCount) {
                if ((existingNode = current.next) == null) {
                    current.next = new DataNode<>(hash, key, value, null);
                    // 链表转红黑树判断
                    if (binCount >= TREEIFY_THRESHOLD - 1)
                        treeifyBin(bucketArray, hash);
                    break;
                }
                if (existingNode.hashVal == hash &&
                    ((existingKey = existingNode.keyRef) == key || (key != null && key.equals(existingKey))))
                    break;
                current = existingNode;
            }
        }

        // 覆盖旧值
        if (existingNode != null) {
            V oldValue = existingNode.valRef;
            if (!onlyIfAbsent || oldValue == null)
                existingNode.valRef = value;
            return oldValue;
        }
    }

    ++modCount;
    // 6. 超过阈值扩容
    if (++size > threshold)
        resize();
    return null;
}
3. 扩容机制 (Resize)
扩容是HashMap中最消耗性能的操作。当元素数量超过阈值时,会将数组容量扩大为原来的2倍,并将所有元素重新映射到新数组。
JDK 1.7 的扩容问题:
在JDK 1.7中,扩容时需要遍历所有元素,重新计算每个元素在新数组中的位置(rehash)。特别地,旧链表迁移到新数组时,采用头插法,这会导致链表元素顺序倒置。这在多线程并发扩容时容易产生死循环(环形链表)。
JDK 1.8 的优化:
JDK 1.8对扩容做了极其巧妙的优化。由于数组长度始终为2的幂次方,扩容后新容量是旧容量的2倍。这意味着,元素在数组中的新索引要么是原索引,要么是"原索引 + 原容量"。
判断依据是:检查元素Hash值中参与计算的那个bit位是0还是1。如果是0,索引不变;如果是1,索引变为原索引 + oldCap。
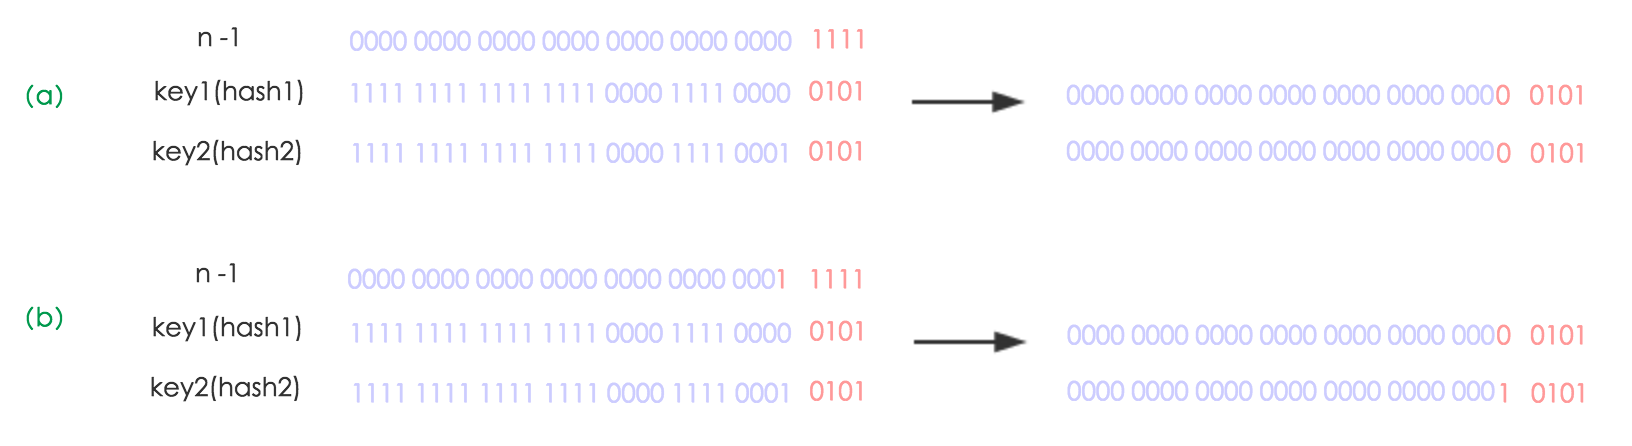
这种设计省去了重新计算Hash的时间,且通过位运算直接确定位置。同时,由于链表迁移时通过loHead/loTail和hiHead/hiTail指针分别处理原索引和原索引+偏移量的节点,保持了原有链表的顺序(尾插法),避免了JDK 1.7的死循环问题。
扩容逻辑核心代码重构:
final DataNode<K,V>[] resize() {
    DataNode<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int oldThr = threshold;
    int newCap, newThr = 0;

    // 计算新容量
    if (oldCap > 0) {
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                 oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1; // double threshold
    }
    // ... 其他初始化逻辑 ...

    DataNode<K,V>[] newTab = (DataNode<K,V>[])new DataNode[newCap];
    table = newTab;

    if (oldTab != null) {
        for (int j = 0; j < oldCap; ++j) {
            DataNode<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                if (e.next == null)
                    newTab[e.hashVal & (newCap - 1)] = e;
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else { // 链表优化重哈希
                    DataNode<K,V> loHead = null, loTail = null;
                    DataNode<K,V> hiHead = null, hiTail = null;
                    DataNode<K,V> next;
                    do {
                        next = e.next;
                        // (e.hash & oldCap) == 0 表示索引不变
                        if ((e.hashVal & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        // 索引变为 原索引 + oldCap
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);

                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
线程安全性问题
HashMap是非线程安全的。在JDK 1.7中,多线程并发进行put操作触发扩容时,由于transfer方法采用头插法迁移链表,可能导致链表形成环形数据结构。当下一次get操作访问到该环链表时,就会陷入死循环(CPU 100%)。虽然JDK 1.8修正了链表倒置问题,解决了死循环,但在并发环境下仍可能导致数据覆盖丢失。
因此,在多线程环境下,必须使用ConcurrentHashMap或Collections.synchronizedMap。
JDK 1.8 性能对比
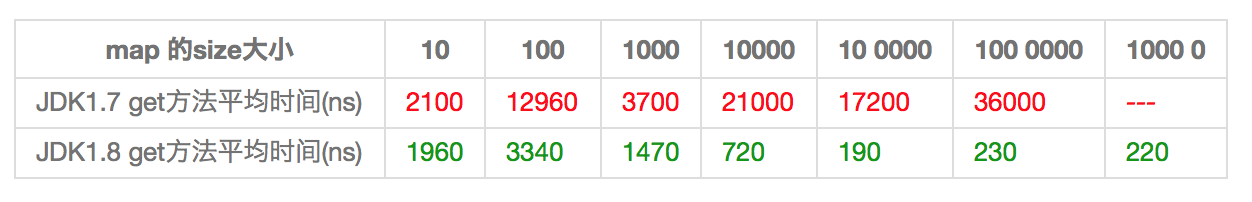
JDK 1.8引入红黑树后,在Hash冲突严重的场景下,性能提升显著。
1. Hash均匀场景:
当Hash算法分散性好时,大部分操作直接命中数组桶,时间复杂度O(1)。此时红黑树优势不明显,但由于JVM优化等综合因素,JDK 1.8通常略快于JDK 1.7。
2. Hash冲突严重场景:
如果Hash算法设计极差,大量元素聚集在同一个桶中。JDK 1.7需要遍历长链表(O(n)),性能随数据量线性下降。而JDK 1.8在链表长度超过8时转换为红黑树,查找复杂度降为O(logn),性能随数据量对数增长,在大数据量下优势巨大。
开发建议总结
- 初始化容量:构建HashMap时尽量预估数据量,指定初始容量,避免频繁扩容带来的性能损耗。
- 负载因子:通常保持默认0.75。仅在内存极其紧张且对读取性能不敏感时,可适当调大;反之亦然。
- 线程安全:多线程环境严禁使用HashMap,优先选择ConcurrentHashMap。
- 版本升级:JDK 1.8对HashMap的优化(特别是红黑树)是巨大的性能飞跃,建议尽可能升级到JDK 8及以上版本。
