Java集合框架深度解析:从基础到Stream API与方法引用
在Java编程中,集合框架是处理数据不可或缺的工具。它提供了一套接口和类,用于存储和操作对象组。本章将深入探讨Java集合框架,从其基本结构、遍历方式,到核心数据结构、泛型,再到高级特性如Stream API和方法引用。
1. 集合体系概览
Java集合框架主要分为两大类:单列集合(Collection)和双列集合(Map)。
- Collection接口(单列集合): 存储单个元素,又可细分为:
- List系列集合: 元素有序(插入顺序),允许重复,支持通过索引访问。
- Set系列集合: 元素无序,不允许重复,不支持索引。
- Map接口(双列集合): 存储键值对,键不可重复,值可以重复,键与值之间存在一对一的映射关系。
2. Collection接口及其常用操作
java.util.Collection 是所有单列集合的根接口,定义了所有单列集合的通用操作,如添加、删除、判断、获取大小等。
2.1 Collection集合的遍历方法
有多种方式可以遍历Collection集合中的元素:
2.1.1 迭代器(Iterator)遍历
迭代器是Java集合框架中专门用于遍历集合的接口。通过调用集合对象的 iterator() 方法可以获取一个迭代器实例。
常用方法:
boolean hasNext():检查序列中是否还有更多元素。E next():返回序列中的下一个元素。void remove():从迭代器上次返回的元素中移除该元素(在next()调用后)。
代码示例:使用迭代器遍历和删除元素
import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class CollectionIteratorDemo {
    public static void main(String[] args) {
        Collection<String> fruitBasket = new ArrayList<>();
        fruitBasket.add("Apple");
        fruitBasket.add("Banana");
        fruitBasket.add("Orange");
        fruitBasket.add("Grape");

        System.out.println("--- 遍历水果篮 ---");
        Iterator<String> fruitIterator = fruitBasket.iterator();
        while (fruitIterator.hasNext()) {
            String fruit = fruitIterator.next();
            System.out.println(fruit);
        }

        System.out.println("\n--- 移除'Banana'后的水果篮 ---");
        fruitIterator = fruitBasket.iterator(); // 重置迭代器
        while (fruitIterator.hasNext()) {
            String fruit = fruitIterator.next();
            if ("Banana".equals(fruit)) {
                fruitIterator.remove(); // 移除当前元素
            }
        }
        System.out.println("剩余水果: " + fruitBasket); // 输出: 剩余水果: [Apple, Orange, Grape]
    }
}
2.1.2 增强for循环 (For-Each Loop)
增强for循环是JDK 5引入的语法糖,用于简化数组和实现 Iterable 接口的集合的遍历。其内部机制仍然是基于迭代器。
语法格式:
for (ElementType elementVariable : collectionOrArray) {
    // 使用 elementVariable
}
代码示例:
import java.util.ArrayList;
import java.util.Collection;

public class EnhancedForLoopDemo {
    public static void main(String[] args) {
        Collection<Integer> numbers = new ArrayList<>();
        numbers.add(10);
        numbers.add(20);
        numbers.add(30);
        numbers.add(40);

        System.out.println("--- 使用增强for循环遍历数字 ---");
        for (Integer num : numbers) {
            System.out.println("数字: " + num);
        }
    }
}
2.1.3 Lambda表达式与forEach方法
Java 8引入的Lambda表达式可以与 Collection 接口的 forEach 方法结合,实现更简洁的遍历方式。
default void forEach(Consumer<? super T> action):对集合中的每个元素执行给定的操作。
代码示例:
import java.util.ArrayList;
import java.util.Collection;

public class LambdaForEachDemo {
    public static void main(String[] args) {
        Collection<String> cities = new ArrayList<>();
        cities.add("New York");
        cities.add("London");
        cities.add("Paris");
        cities.add("Tokyo");

        System.out.println("--- 使用Lambda表达式遍历城市 ---");
        // 传统的匿名内部类方式
        /*
        cities.forEach(new Consumer<String>() {
            @Override
            public void accept(String city) {
                System.out.println("城市: " + city);
            }
        });
        */

        // Lambda表达式简化形式
        cities.forEach(city -> System.out.println("城市: " + city));
    }
}
3. List接口及其特性
java.util.List 继承自 Collection 接口,代表一个有序的集合(也称为序列)。它的主要特点包括:
- 有序性: 元素的插入顺序与遍历顺序一致。
- 索引访问: 可以通过整数索引访问、插入或删除元素。
- 允许重复: 集合中可以包含重复的元素。
除了继承自 Collection 的方法外,List 接口还提供了一系列基于索引的操作方法,例如:
void add(int index, E element):在指定位置插入元素。E get(int index):返回指定位置的元素。E remove(int index):移除指定位置的元素。E set(int index, E element):替换指定位置的元素。
4. 核心数据结构
数据结构是组织和存储数据的方式,它直接影响程序的效率。选择合适的数据结构对性能至关重要。
4.1 栈 (Stack)
- 特性: 后进先出 (LIFO - Last In, First Out)。
- 操作: 压栈(push)将元素添加到顶部,弹栈(pop)从顶部移除元素。
4.2 队列 (Queue)
- 特性: 先进先出 (FIFO - First In, First Out)。
- 操作: 入队将元素添加到尾部,出队从头部移除元素。
4.3 数组 (Array)
- 特性: 基于索引存储,查找速度快(O(1)),增删(尤其是中间位置)速度慢(O(n))。
- 内存: 内存连续。
4.4 ArrayList集合
- 底层实现: 动态数组。
- 性能特点: 查询效率高,增删效率相对较低(特别是中间位置)。
4.5 LinkedList集合
- 底层实现: 双向链表。
- 性能特点: 查询效率低,增删效率高。
代码示例:LinkedList 作为双端队列的运用
import java.util.LinkedList;

public class LinkedListOperations {
    public static void main(String[] args) {
        LinkedList<String> taskQueue = new LinkedList<>();

        System.out.println("--- 模拟任务队列 ---");
        // 添加任务到队尾 (addLast)
        taskQueue.addLast("Task A");
        taskQueue.addLast("Task B");
        System.out.println("当前队列: " + taskQueue); // [Task A, Task B]

        // 紧急任务插入队头 (addFirst)
        taskQueue.addFirst("Urgent Task");
        System.out.println("加入紧急任务后: " + taskQueue); // [Urgent Task, Task A, Task B]

        // 查看队头和队尾元素 (getFirst, getLast)
        System.out.println("队头任务: " + taskQueue.getFirst()); // Urgent Task
        System.out.println("队尾任务: " + taskQueue.getLast());   // Task B

        // 处理队头任务 (removeFirst)
        String processedTask1 = taskQueue.removeFirst();
        System.out.println("处理任务: " + processedTask1); // Urgent Task
        System.out.println("处理后队列: " + taskQueue); // [Task A, Task B]

        // 处理队尾任务 (removeLast)
        String processedTask2 = taskQueue.removeLast();
        System.out.println("完成任务: " + processedTask2); // Task B
        System.out.println("完成一部分后队列: " + taskQueue); // [Task A]
    }
}
5. 泛型 (Generics)
泛型是JDK 5引入的特性,提供编译时类型安全检测机制,允许在定义类、接口和方法时使用类型参数。它带来了以下好处:
- 编译时类型检查: 将运行时错误提前到编译时发现。
- 消除强制类型转换: 减少代码冗余和潜在的
ClassCastException。
定义格式:
<Type>:单个类型参数,如<E>(Element),<T>(Type)。<Type1, Type2...>:多个类型参数,如<K, V>(Key, Value)。
6. 树形数据结构(二叉查找树、红黑树)
6.1 二叉树 (Binary Tree)
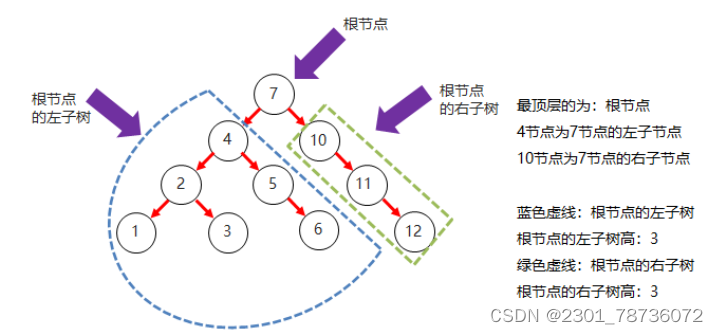
二叉树是一种特殊的树形数据结构,每个节点最多有两个子节点(通常称为左子节点和右子节点)。
关键概念:
- 节点 (Node): 树中的每个元素。
- 度 (Degree): 一个节点拥有的子节点的数量。在二叉树中,任何节点的度都小于等于2。
6.2 二叉查找树 (Binary Search Tree - BST)
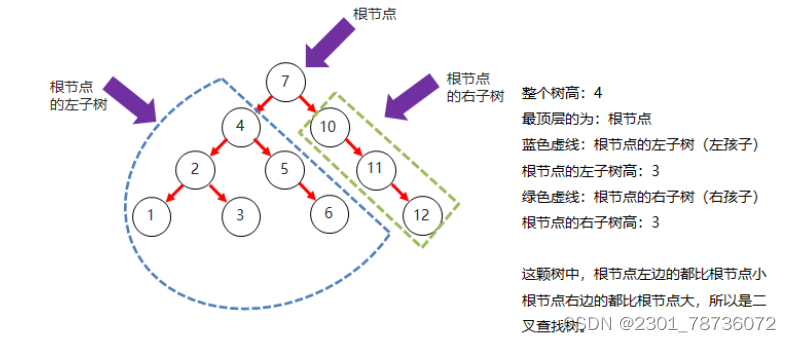
二叉查找树(也称二叉排序树或二叉搜索树)是二叉树的一种特殊形式,它具备以下特性:
- 每个节点最多有两个子节点。
- 左子树中所有节点的值都小于根节点的值。
- 右子树中所有节点的值都大于根节点的值。
- 左右子树本身也必须是二叉查找树。
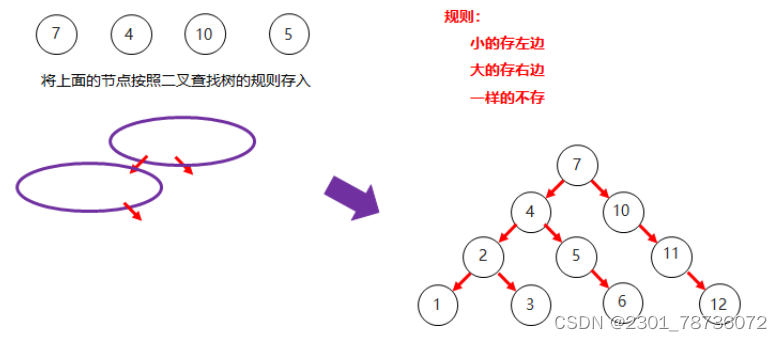
节点添加规则: 小的值存左边,大的值存右边,相同的值不存储。
6.3 平衡二叉树 (Balanced Binary Tree)
平衡二叉树(如AVL树)是一种特殊的二叉查找树,它通过保持树的左右子树高度差不超过1来确保查找效率。当插入或删除节点导致不平衡时,会触发旋转操作(左旋、右旋、左右旋、右左旋)来重新平衡树。
6.4 红黑树 (Red-Black Tree)
红黑树是一种自平衡二叉查找树,它通过为每个节点着色(红或黑)并遵循一组规则来保持平衡,以确保查找、插入和删除操作的对数时间复杂度。
红黑树规则:
- 每个节点是红色或黑色。
- 根节点是黑色。
- 所有叶子节点(NIL节点,表示空节点)是黑色。
- 如果一个节点是红色的,则它的两个子节点必须是黑色的(不能有两个连续的红色节点)。
- 从任意节点到其每个叶子节点的所有简单路径都包含相同数量的黑色节点。
7. Set接口及其实现
java.util.Set 继承自 Collection 接口,代表一个不包含重复元素的集合。它的主要特点是:
- 不允许重复: 相同的元素只能存在一个。
- 无序性: 大多数Set实现不保证元素的存储顺序,也不支持通过索引访问。
7.1 TreeSet集合
java.util.TreeSet 是 Set 接口的一个实现,它使用红黑树作为底层数据结构,因此其元素会根据自然顺序(实现了 Comparable 接口)或自定义的比较器(Comparator)进行排序。
TreeSet():根据元素的自然排序进行排序。TreeSet(Comparator comparator):根据指定的比较器进行排序。
代码示例:使用TreeSet存储并排序元素
import java.util.Set;
import java.util.TreeSet;

public class TreeSetDemo {
    public static void main(String[] args) {
        Set<Integer> uniqueNumbers = new TreeSet<>();
        uniqueNumbers.add(50);
        uniqueNumbers.add(20);
        uniqueNumbers.add(80);
        uniqueNumbers.add(10);
        uniqueNumbers.add(50); // 重复元素,不会被添加

        System.out.println("--- TreeSet存储的唯一且有序的数字 ---");
        for (Integer num : uniqueNumbers) {
            System.out.println(num); // 输出: 10, 20, 50, 80 (已排序)
        }
    }
}
8. Map接口(双列集合)
java.util.Map 接口用于存储键值对(Key-Value Pair),其中每个键唯一,且每个键都映射到一个值。Map中的键值对也常被称为"Entry对象"。
特性:
- 存储一对数据:键和值。
- 键不允许重复,值可以重复。
- 每个键唯一对应一个值。
8.1 Map的常见API与遍历方式
Map 接口定义了双列集合的通用操作,如 put()、get()、remove()、containsKey() 等。
put(K key, V value) 方法的细节:
- 如果键不存在,则添加新的键值对,返回
null。 - 如果键已存在,则用新值覆盖旧值,并返回被覆盖的旧值。
Map的遍历方式:
8.1.1 遍历键集(KeySet)
- 通过
keySet()方法获取所有键的Set集合。 - 遍历键集合,获取每一个键。
- 通过
get(Object key)方法根据键获取对应的值。
代码示例:
import java.util.HashMap;
import java.util.Map;
import java.util.Set;

public class MapTraversalByKeySet {
    public static void main(String[] args) {
        Map<String, String> studentGrades = new HashMap<>();
        studentGrades.put("Alice", "A+");
        studentGrades.put("Bob", "B");
        studentGrades.put("Charlie", "A");

        System.out.println("--- 遍历学生成绩 (通过KeySet) ---");
        Set<String> studentNames = studentGrades.keySet();
        for (String name : studentNames) {
            String grade = studentGrades.get(name);
            System.out.println("姓名: " + name + ", 成绩: " + grade);
        }
    }
}
8.1.2 遍历键值对集(EntrySet)
- 通过
entrySet()方法获取所有键值对(Map.Entry对象)的Set集合。 - 遍历
Entry集合,获取每一个Map.Entry对象。 - 通过
getKey()和getValue()方法从Map.Entry对象中获取键和值。
代码示例:
import java.util.HashMap;
import java.util.Map;
import java.util.Set;

public class MapTraversalByEntrySet {
    public static void main(String[] args) {
        Map<String, String> countryCapitals = new HashMap<>();
        countryCapitals.put("USA", "Washington D.C.");
        countryCapitals.put("France", "Paris");
        countryCapitals.put("Japan", "Tokyo");

        System.out.println("--- 遍历国家首都 (通过EntrySet) ---");
        Set<Map.Entry<String, String>> entries = countryCapitals.entrySet();
        for (Map.Entry<String, String> entry : entries) {
            String country = entry.getKey();
            String capital = entry.getValue();
            System.out.println("国家: " + country + ", 首都: " + capital);
        }
    }
}
8.2 HashMap
java.util.HashMap 是 Map 接口最常用的实现类。它使用哈希表作为底层数据结构,提供快速的存取速度。
- 特性: 键是无序的、不重复的,没有索引。
- 原理: 与
HashSet底层原理相同,都基于哈希表。
8.3 LinkedHashMap
java.util.LinkedHashMap 继承自 HashMap,它在哈希表的基础上,通过维护一个双向链表来记录元素的插入顺序。
- 特性: 键是有序的(按插入顺序)、不重复的,没有索引。
- 原理: 哈希表 + 双向链表。
8.4 TreeMap
java.util.TreeMap 是 Map 接口的另一个实现,它使用红黑树作为底层数据结构,能够对键进行排序。
- 特性: 键是不重复的、无索引的、可排序的。
- 排序规则: 默认按照键的自然顺序排序,或通过提供
Comparator对象进行自定义排序。
9. 可变参数 (Varargs)
可变参数是JDK 5引入的特性,允许方法接受不定数量的同类型参数。本质上,可变参数在方法内部被视为一个数组。
语法格式: 数据类型... 参数名称,例如 int... numbers。
注意事项:
- 一个方法的形参列表中只能有一个可变参数。
- 可变参数必须放在形参列表的最后面。
10. Collections 工具类
java.util.Collections 是一个工具类,提供了对集合进行操作的静态方法,例如排序、查找、同步化等。
常用API示例:
sort(List<T> list):对列表进行排序。shuffle(List<?> list):随机打乱列表元素的顺序。reverse(List<?> list):反转列表中元素的顺序。max(Collection<? extends T> coll):返回集合中的最大元素。min(Collection<? extends T> coll):返回集合中的最小元素。
11. 不可变集合 (Immutable Collections)
JDK 9 引入了不可变集合的工厂方法,用于创建在初始化后无法修改(添加、删除或修改元素)的集合。
创建方式: 在 List, Set, Map 接口中,提供了静态的 of() 或 copyOf() 方法。
不可变List示例:
import java.util.List;
import java.util.ArrayList; // 用于 copyOf 示例

public class ImmutableListDemo {
    public static void main(String[] args) {
        // 使用 List.of() 创建不可变List (元素数量有限制,通常不超过10)
        List<String> fruits = List.of("Apple", "Banana", "Cherry");
        System.out.println("不可变水果列表: " + fruits);

        // 尝试修改会抛出 UnsupportedOperationException
        // fruits.add("Date"); // 运行时错误
        // fruits.set(0, "Apricot"); // 运行时错误

        System.out.println("第一个水果: " + fruits.get(0));

        // 也可以从现有集合创建不可变集合
        ArrayList<String> mutableColors = new ArrayList<>();
        mutableColors.add("Red");
        mutableColors.add("Green");
        List<String> immutableColors = List.copyOf(mutableColors);
        System.out.println("不可变颜色列表: " + immutableColors);
        // immutableColors.add("Blue"); // 运行时错误
    }
}
不可变Set示例:
import java.util.Set;

public class ImmutableSetDemo {
    public static void main(String[] args) {
        // Set.of() 要求所有元素唯一
        Set<Integer> uniqueNums = Set.of(1, 2, 3, 4, 5);
        System.out.println("不可变数字集合: " + uniqueNums);
        // uniqueNums.add(6); // 运行时错误
        // Set.of(1, 1, 2); // 如果参数重复,会抛出 IllegalArgumentException
    }
}
不可变Map示例 (键值对数量 <= 10):
import java.util.Map;
import java.util.Set;

public class ImmutableMapSmallDemo {
    public static void main(String[] args) {
        // Map.of() 支持最多10个键值对
        Map<String, Integer> studentScores = Map.of(
            "David", 95, "Emily", 88, "Frank", 92, "Grace", 79
        );
        System.out.println("不可变学生分数Map: " + studentScores);

        // 遍历
        for (Map.Entry<String, Integer> entry : studentScores.entrySet()) {
            System.out.println(entry.getKey() + " -> " + entry.getValue());
        }

        // studentScores.put("Hannah", 85); // 运行时错误
    }
}
不可变Map示例 (键值对数量 > 10 或从现有Map创建):
import java.util.HashMap;
import java.util.Map;
import java.util.Set;

public class ImmutableMapLargeDemo {
    public static void main(String[] args) {
        HashMap<String, String> mutableSettings = new HashMap<>();
        mutableSettings.put("theme", "dark");
        mutableSettings.put("language", "en");
        mutableSettings.put("fontSize", "14px");
        mutableSettings.put("notifications", "enabled");
        mutableSettings.put("cache", "on");
        mutableSettings.put("proxy", "none");
        mutableSettings.put("logging", "debug");
        mutableSettings.put("timeout", "30s");
        mutableSettings.put("region", "us-east");
        mutableSettings.put("timezone", "UTC");
        mutableSettings.put("adminEmail", "admin@example.com"); // 超过10个

        // 使用 Map.copyOf() 从现有Map创建不可变Map
        Map<String, String> immutableSettings = Map.copyOf(mutableSettings);
        System.out.println("不可变系统设置: " + immutableSettings);
        // immutableSettings.put("newKey", "newValue"); // 运行时错误
    }
}
12. Stream API
Stream API (流API) 是JDK 8引入的一项强大功能,它结合了Lambda表达式,以声明式的方式处理集合、数组或其他数据源的数据,极大地简化了常见的集合操作。
使用步骤:
- 获取Stream流: 从集合、数组、Map或其他数据源创建Stream对象。
- 执行中间操作 (Intermediate Operations): 对Stream中的元素进行转换、过滤、排序等操作,这些操作会返回一个新的Stream,并可以链式调用。中间操作是惰性执行的。
- 执行终结操作 (Terminal Operations): 触发Stream的实际执行,并产生最终结果或副作用(如打印)。终结操作之后,Stream就不能再使用了。
代码示例:获取Stream流
import java.util.ArrayList;
import java.util.Arrays;
import java.util.HashMap;
import java.util.Map;
import java.util.stream.Stream;

public class StreamCreationDemo {
    public static void main(String[] args) {
        // 1. 从单列集合获取Stream
        ArrayList<String> names = new ArrayList<>();
        names.add("Alice");
        names.add("Bob");
        names.add("Charlie");
        System.out.println("--- 集合Stream ---");
        names.stream().forEach(System.out::println);

        // 2. 从双列集合获取Stream (通过KeySet或EntrySet)
        Map<String, Integer> scores = new HashMap<>();
        scores.put("Math", 90);
        scores.put("English", 85);
        System.out.println("\n--- Map KeySet Stream ---");
        scores.keySet().stream().forEach(key -> System.out.println("科目: " + key));
        System.out.println("\n--- Map EntrySet Stream ---");
        scores.entrySet().stream().forEach(entry -> System.out.println(entry.getKey() + ": " + entry.getValue()));

        // 3. 从数组获取Stream
        int[] intArray = {1, 2, 3, 4, 5};
        String[] stringArray = {"one", "two", "three"};
        System.out.println("\n--- 整型数组Stream ---");
        Arrays.stream(intArray).forEach(System.out::println);
        System.out.println("\n--- 字符串数组Stream ---");
        Arrays.stream(stringArray).forEach(System.out::println);

        // 4. 从零散数据获取Stream
        System.out.println("\n--- 零散数据Stream ---");
        Stream.of("A", "B", "C", "D").forEach(System.out::println);
    }
}
12.1 Stream中间操作
中间操作会返回一个新的 Stream 对象,允许进行链式调用。它们不会立即执行,而是等到终结操作被调用时才一起执行(惰性求值)。中间操作不会修改原始数据源。
filter(Predicate<? super T> predicate):根据条件过滤元素。map(Function<? super T, ? extends R> mapper):将一种类型的元素转换成另一种类型。distinct():去除重复元素。sorted()/sorted(Comparator<? super T> comparator):排序元素。limit(long maxSize):截断Stream,使其元素不超过指定数量。skip(long n):跳过Stream中的前n个元素。
12.2 Stream终结操作
终结操作会消耗Stream,执行Stream管道中的所有操作,并产生一个结果或副作用。一个Stream只能执行一次终结操作。
forEach(Consumer<? super T> action):对每个元素执行操作。count():返回Stream中元素的数量。collect(Collector<? super T, A, R> collector):将Stream中的元素收集到集合、Map或其他数据结构中。toArray()/toArray(IntFunction<A[]> generator):将Stream元素收集到数组中。min(Comparator<? super T> comparator)/max(Comparator<? super T> comparator):查找最小/最大元素。reduce():将Stream中的元素聚合成一个值。
13. 方法引用 (Method References)
方法引用是Java 8的特性,它是一种简化Lambda表达式的语法糖,可以直接引用已有的方法作为函数式接口的实现。它提供了更简洁、可读性更高的代码。
使用条件:
- 引用处必须是函数式接口。
- 被引用的方法必须已经存在。
- 被引用方法的参数列表和返回值类型必须与函数式接口的抽象方法的参数列表和返回值类型兼容。
语法: :: 是方法引用操作符。
代码示例:使用方法引用进行排序
import java.util.Arrays;
import java.util.Comparator;

public class MethodReferenceSortDemo {
    public static void main(String[] args) {
        Integer[] nums = {4, 5, 1, 8, 2, 7, 3};

        // 匿名内部类实现降序
        /*
        Arrays.sort(nums, new Comparator<Integer>() {
            @Override
            public int compare(Integer o1, Integer o2) {
                return o2 - o1;
            }
        });
        */

        // Lambda表达式实现降序
        // Arrays.sort(nums, (a, b) -> b - a);

        // 方法引用实现降序(定义一个静态方法)
        Arrays.sort(nums, MethodReferenceSortDemo::compareDescending);
        System.out.println("降序排序: " + Arrays.toString(nums));
    }

    // 静态方法,用于Comparator的比较逻辑
    public static int compareDescending(int n1, int n2) {
        return n2 - n1;
    }
}
13.1 方法引用的分类
13.1.1 引用静态方法
格式: 类名::静态方法名
代码示例:字符串转换为整数
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

public class StaticMethodRefDemo {
    public static void main(String[] args) {
        ArrayList<String> strNumbers = new ArrayList<>();
        Collections.addAll(strNumbers, "10", "20", "30", "40", "50");

        // 使用Lambda表达式
        // List<Integer> intNumbers = strNumbers.stream().map(s -> Integer.parseInt(s)).toList();

        // 使用静态方法引用 Integer::parseInt
        List<Integer> intNumbers = strNumbers.stream().map(Integer::parseInt).toList();
        System.out.println("字符串转换为整数列表: " + intNumbers);
    }
}
13.1.2 引用对象的实例方法
格式: 对象::实例方法名
代码示例:过滤符合条件的字符串
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.function.Predicate;

public class InstanceMethodRefDemo {
    public static void main(String[] args) {
        List<String> names = new ArrayList<>();
        Collections.addAll(names, "zhangsan", "lisi", "wangwu", "zhangxiao", "zhaoliu");

        NameFilter filter = new NameFilter(); // 创建一个对象

        // 使用Lambda表达式
        // names.stream().filter(s -> filter.isQualified(s)).forEach(System.out::println);

        // 使用对象实例方法引用
        names.stream().filter(filter::isQualified).forEach(System.out::println);
    }
}

class NameFilter {
    // 检查名字是否以"zhang"开头且长度大于5
    public boolean isQualified(String name) {
        return name.startsWith("zhang") && name.length() > 5;
    }
}
13.1.3 引用构造方法
格式: 类名::new
代码示例:将字符串转换为自定义对象
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.stream.Collectors;

public class ConstructorRefDemo {
    public static void main(String[] args) {
        ArrayList<String> studentDataList = new ArrayList<>();
        Collections.addAll(studentDataList, "Alice,20", "Bob,22", "Charlie,21");

        // 使用Lambda表达式
        /*
        List<StudentInfo> studentObjs = studentDataList.stream().map(s -> {
            String[] parts = s.split(",");
            return new StudentInfo(parts[0], Integer.parseInt(parts[1]));
        }).collect(Collectors.toList());
        */

        // 使用构造方法引用 StudentInfo::new
        List<StudentInfo> studentObjs = studentDataList.stream().map(StudentInfo::new).collect(Collectors.toList());
        System.out.println("学生对象列表: " + studentObjs);
    }
}

class StudentInfo {
    private String name;
    private int age;

    // 构造方法,接收 "name,age" 格式的字符串
    public StudentInfo(String data) {
        String[] parts = data.split(",");
        this.name = parts[0];
        this.age = Integer.parseInt(parts[1]);
    }

    public StudentInfo(String name, int age) { // 也可以提供这种构造函数
        this.name = name;
        this.age = age;
    }

    @Override
    public String toString() {
        return "StudentInfo{" + "name='" + name + '\'' + ", age=" + age + '}';
    }
}
13.1.4 引用特定类型对象的实例方法
格式: 类名::实例方法名(当Lambda的第一个参数是该方法的调用者时)
代码示例:字符串转换为大写
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

public class TypeInstanceMethodRefDemo {
    public static void main(String[] args) {
        List<String> lowerCaseWords = new ArrayList<>();
        Collections.addAll(lowerCaseWords, "alpha", "beta", "gamma");

        // 使用Lambda表达式
        // List<String> upperCaseWords = lowerCaseWords.stream().map(s -> s.toUpperCase()).toList();

        // 使用特定类型对象的实例方法引用 String::toUpperCase
        List<String> upperCaseWords = lowerCaseWords.stream().map(String::toUpperCase).toList();
        System.out.println("转换为大写: " + upperCaseWords);
    }
}
13.1.5 引用数组构造方法
格式: 数组类型::new
代码示例:将Stream中的整数收集到数组中
import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;

public class ArrayConstructorRefDemo {
    public static void main(String[] args) {
        ArrayList<Integer> intList = new ArrayList<>();
        Collections.addAll(intList, 10, 20, 30, 40, 50);

        // 使用Lambda表达式
        // Integer[] intArray = intList.stream().toArray(len -> new Integer[len]);

        // 使用数组构造方法引用 Integer[]::new
        Integer[] intArray = intList.stream().toArray(Integer[]::new);
        System.out.println("Stream收集到数组: " + Arrays.toString(intArray));
    }
}
