一、前端概念与技术栈
Web前端开发专注于构建用户在浏览器中直接互动和感知的部分,即用户界面(UI)。它负责数据的呈现、用户交互逻辑的实现以及确保跨设备的良好体验。
1. 前端与后端的职责划分
- 前端(Client-side):指的是Web应用中直接与用户交互的界面层。它处理视图的渲染、用户输入、动画效果及与后端API的通信,使用户能够直观地操作和体验应用。
- 后端(Server-side):负责处理前端发送的各种请求,执行业务逻辑,管理数据库交互,并向前端返回所需的数据或处理结果。它是应用的数据和业务核心支撑。
2. 前端开发的关键技术
现代前端开发是一个多技术融合的领域,核心组成包括:
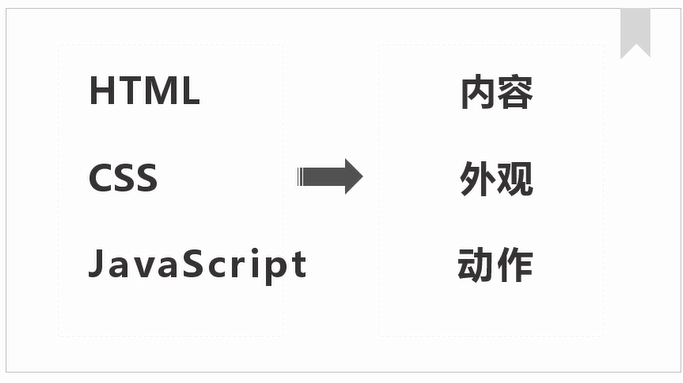
- HTML(超文本标记语言):定义网页的骨架和内容结构,如标题、段落、图片、链接等。
- CSS(层叠样式表):控制网页的外观和布局,包括字体、颜色、大小、边距以及响应式设计等。
- JavaScript:赋予网页动态功能和交互性,处理用户事件、发送网络请求、修改DOM元素等。
- 前端框架/库:如React、Vue.js、Angular等,提供组件化开发、数据管理、路由等高级功能,大幅提升开发效率和项目可维护性。
- 版本控制系统:Git是主流工具,用于代码管理、协作开发和历史版本追踪。
- 构建工具:Webpack、Vite、Parcel等,自动化处理模块打包、代码压缩、转译等任务,优化前端项目的性能和开发流程。
- 调试工具:浏览器内置的开发者工具(如Chrome DevTools)是调试、性能分析和排查前端问题的利器。
- 响应式设计:确保网页能在不同尺寸的设备(手机、平板、桌面)上提供一致且优化的用户体验。
- 性能优化:通过各种技术手段提升网页加载速度和运行效率,改善用户体验并有利于搜索引擎优化(SEO)。
3. HTML、CSS、JavaScript:Web三剑客
HTML、CSS和JavaScript是构建任何Web页面的基石,它们各司其职,共同协作:
- HTML(HyperText Markup Language):如同人体骨架,它定义了网页的结构和内容,是信息的载体。没有HTML,网页将是一片空白。
- CSS(Cascading Style Sheets):好比衣物和装扮,负责美化网页,控制元素的样式、布局和视觉呈现,让网页赏心悦目。
- JavaScript:则是让网页动起来的神经与肌肉,它处理用户交互、响应事件、动态修改内容,使网页具备生命力和丰富的互动性。
二、浏览器与网络通信基础
浏览器不仅是前端代码的执行环境,更是用户访问互联网资源的门户。理解其工作机制对于前端开发至关重要。
1. 浏览器作为前端代码执行器
浏览器扮演着前端代码的"解释器"角色,它能够解析和执行HTML、CSS和JavaScript,将抽象的代码转化为用户可见的交互界面。本质上,浏览器是一个功能强大的客户端,能够与各种服务器进行通信,例如访问电商网站、视频平台等。
2. 从输入URL到页面呈现的全过程
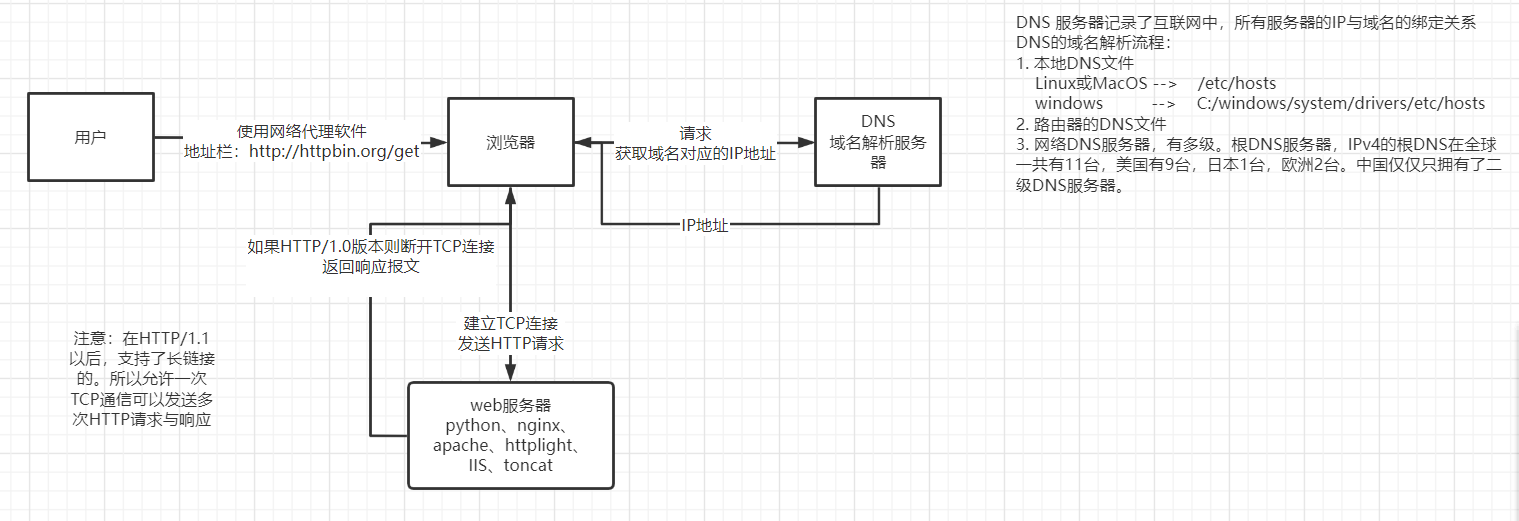
当用户在浏览器地址栏输入一个URL并回车时,一系列复杂的网络和渲染过程随即启动,直至页面完整显示:
- DNS解析:浏览器首先需要将域名(如`www.example.com`)解析成对应的IP地址。它会查询本地缓存、操作系统DNS缓存、本地域名服务器等,最终获取到目标服务器的IP地址。
- 建立TCP连接:获得IP地址后,浏览器会与目标服务器建立一个可靠的TCP连接。这是一个"三次握手"过程,确保数据传输的可靠性。
- 发送HTTP请求:TCP连接建立后,浏览器向服务器发送一个HTTP请求报文,包含请求方法(如GET)、请求路径、HTTP协议版本、请求头和可能的请求体。
- 服务器处理请求:服务器接收请求后,根据请求内容进行处理。这可能涉及到查询数据库、执行业务逻辑、读取文件等操作,并生成相应的HTTP响应。
- 返回HTTP响应:服务器将处理结果封装成HTTP响应报文,发送回浏览器。响应报文包含状态码、响应头和响应体(通常是HTML、CSS、JavaScript等资源)。
- 浏览器解析与渲染:
- 浏览器接收到响应后,首先解析HTML构建DOM树(文档对象模型)。
- 同时解析CSS构建CSSOM树(CSS对象模型)。
- DOM树和CSSOM树结合生成渲染树(Render Tree),包含所有可见元素及其计算样式。
- 浏览器进行布局(Layout/Reflow),计算每个元素在屏幕上的确切位置和大小。
- 最后进行绘制(Painting),将渲染树的像素点绘制到屏幕上。
- 页面加载完成:当所有资源(包括图片、脚本等)都被下载、解析并渲染完毕,页面状态变为加载完成,用户可以进行交互。
3. 超文本传输协议(HTTP)
HTTP(HyperText Transfer Protocol)是Web上数据传输的基础协议,它位于TCP/IP协议族的应用层,负责客户端与服务器之间超文本(如HTML、CSS、JS、图片等)的交换。
3.1 HTTP协议简介
- HTTP协议最初由蒂姆·伯纳斯-李于1989年提出,旨在实现互联网上的文档传输。它是一种无状态(Stateless)的应用层协议。
- HTTP协议构建在TCP/IP协议之上,这意味着它利用TCP提供的可靠连接进行数据传输。
- 它主要用于传输各类Web资源,包括网页、样式表、脚本文件、图像、音视频等。
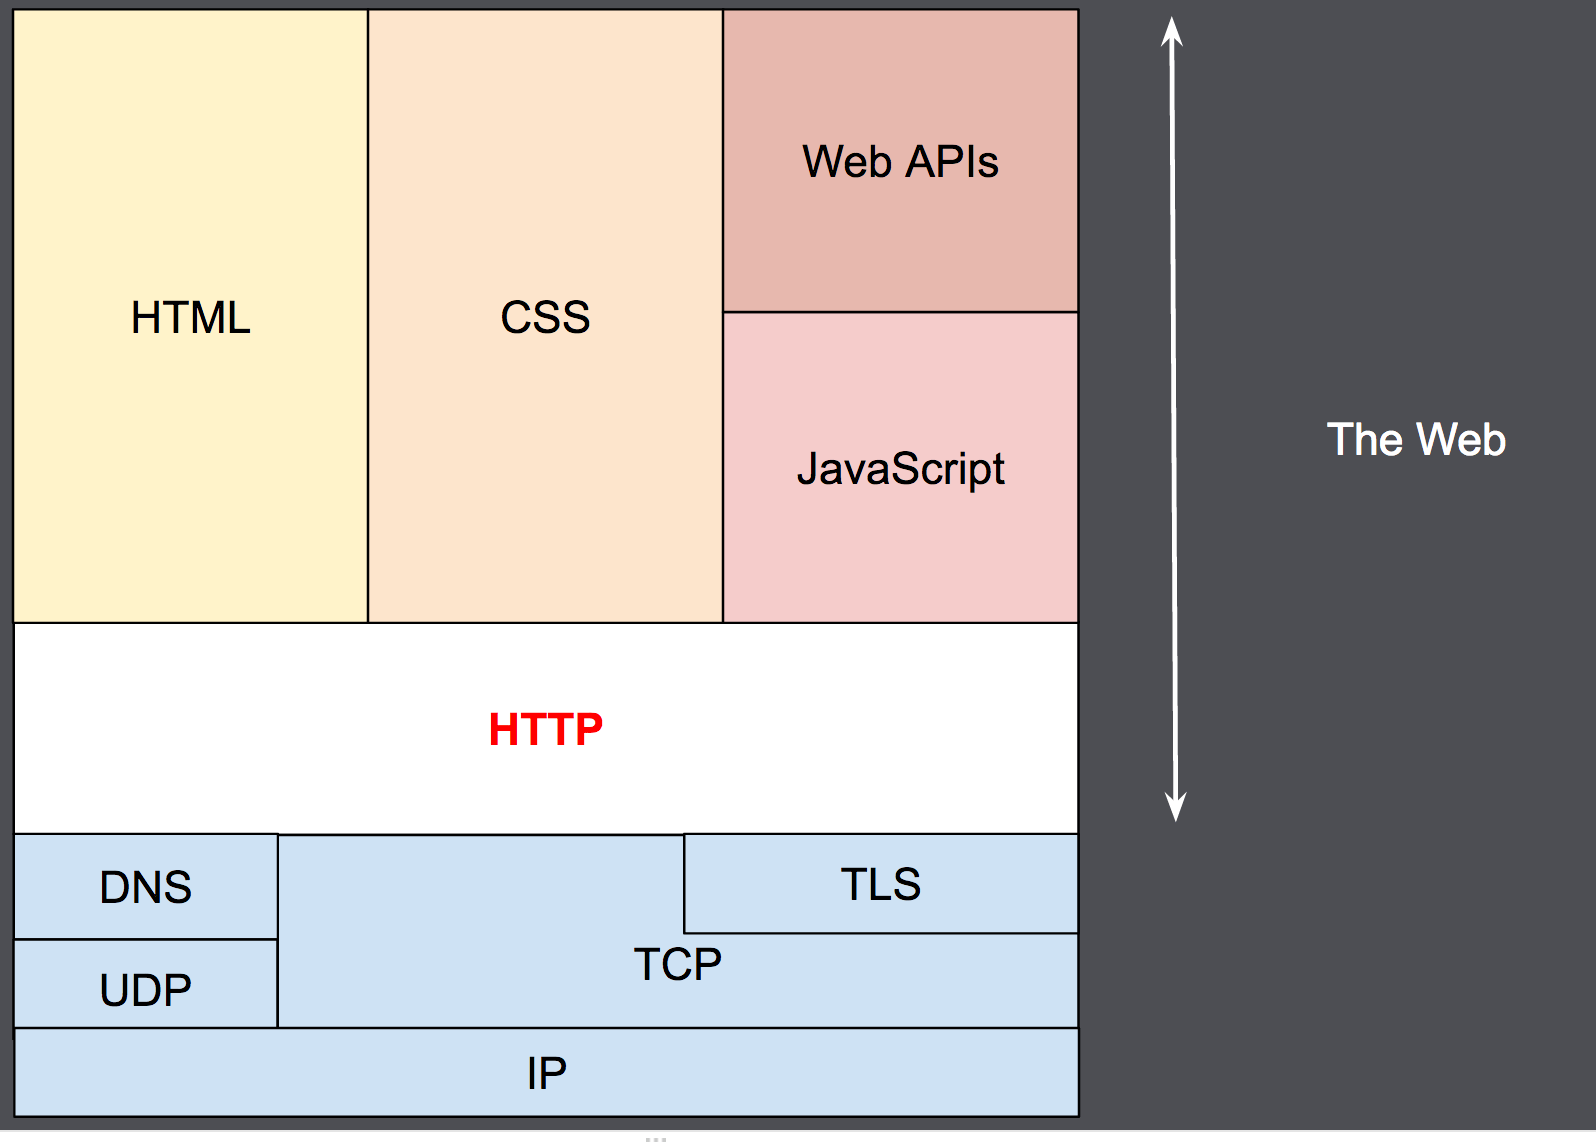
当前HTTP协议根据数据传输是否加密,主要分为两种:
- HTTP:直接基于TCP协议传输数据,不进行加密。默认使用80端口进行通信。
- HTTPS:在HTTP与TCP之间增加了TLS/SSL协议层,对传输数据进行加密,提供更高的安全性。默认使用443端口进行通信。
此外,值得注意的是,直接双击本地HTML文件在浏览器中打开,使用的是`file`协议,而非HTTP/HTTPS。`file`协议仅用于访问本地文件系统资源,无法用于跨网络的文件访问。
3.2 HTTP协议的核心特性
- 无连接性:每次HTTP请求都是独立的,服务器处理完请求并返回响应后,便会断开连接,不会保持客户端的状态。
- 无状态性:服务器不会记录客户端之前的请求或会话信息。每个请求都被视为全新的,独立处理。若需维持状态,需借助Cookie、Session等机制。
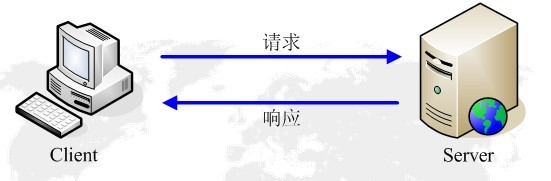
- 请求-响应模型:HTTP协议的基本工作模式。客户端(通常是浏览器)发送请求,服务器接收、处理并返回响应。
- 多种请求方法:定义了GET、POST、PUT、DELETE、HEAD等多种请求方法,每种方法对应不同的资源操作语义。
- 支持状态码:HTTP响应中包含三位数字状态码,表示请求的处理结果,如200(成功)、404(未找到)、500(服务器错误)等。
- 支持缓存机制:通过协商缓存和强缓存机制,减少不必要的网络请求,提高页面加载速度。
3.3 HTTP请求-响应模型详解
HTTP协议遵循严格的请求-响应模式,由客户端发起,服务器回应:
1.
客户端发起请求:
* 浏览器构造一个HTTP请求报文,包含请求行(方法、路径、协议版本)、请求头(如User-Agent、Accept等)和可选的请求体(如POST请求的数据)。
* 通过已建立的TCP连接将请求发送给服务器。
2.
服务器接收并处理请求:
* 服务器接收到客户端的HTTP请求报文。
* 解析请求报文,根据其中的方法、路径、参数等信息,执行相应的业务逻辑(如查询数据库、读取文件、计算结果)。
3.
服务器发送响应:
* 服务器完成处理后,生成一个HTTP响应报文,包含状态行(协议版本、状态码、状态信息)、响应头(如Content-Type、Content-Length等)和响应体(实际数据,如HTML文档、JSON数据)。
* 通过TCP连接将响应发送回客户端。
4.
客户端接收并处理响应:
* 浏览器接收到服务器的HTTP响应报文。
* 解析响应报文,根据状态码判断处理结果,并根据响应头和响应体的内容进行相应操作(如渲染HTML页面、执行JavaScript、显示图片或提示错误)。
4. HTTP报文结构
HTTP协议的通信信息被封装在HTTP报文中。在HTTP/1.1及更早版本中,报文是文本可读的;而在HTTP/2中,报文被拆分为二进制帧,但其语义结构保持不变。
4.1 请求报文
客户端向服务器发送的HTTP请求报文通常包含以下部分:
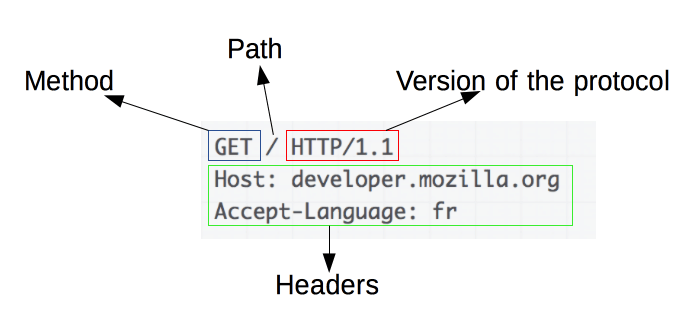
GET /path/to/resource?param=value HTTP/1.1
Host: www.example.com
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
Accept-Encoding: gzip, deflate, br
Accept-Language: en-US,en;q=0.9,zh-CN;q=0.8,zh;q=0.7
Connection: keep-alive

[请求体,对于GET请求通常为空]
其中主要组成部分有:
- 请求行(Request Line):
- HTTP方法:如GET、POST、PUT、DELETE等,定义客户端期望对资源执行的操作。
- 请求URI:指定请求资源的路径,通常是URL中去除协议、主机和端口后的部分。
- HTTP协议版本:如HTTP/1.1。
- 请求头(Request Headers):一系列键值对,提供关于客户端、请求参数或请求体内容的额外信息,如`Host`、`User-Agent`、`Accept`等。
- 空行:一个空行(由一对回车符和换行符`\r\n`组成)用于分隔请求头和请求体。
- 请求体(Request Body):可选部分,用于发送数据给服务器,例如POST请求提交的表单数据或JSON数据。
使用Python Socket模块查看请求报文
以下是一个简单的Python服务器,用于监听特定端口并打印接收到的HTTP请求报文:
import socket

# 服务器配置
SERVER_HOST = '127.0.0.1'
SERVER_PORT = 8000 # 使用一个常用的开发端口

# 创建一个TCP套接字
server_sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
# 允许立即重用端口
server_sock.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)

server_sock.bind((SERVER_HOST, SERVER_PORT))
server_sock.listen(1) # 监听一个连接

print(f"服务器已启动,正在监听 {SERVER_HOST}:{SERVER_PORT}...")

while True:
    client_conn, client_addr = server_sock.accept()
    print(f"接收到来自 {client_addr} 的连接")

    # 接收客户端请求数据,并尝试解码
    # 增加缓冲区大小以确保能完整接收请求头
    try:
        request_bytes = client_conn.recv(4096)
        http_request_str = request_bytes.decode('utf-8')
        print("\n--- 接收到的HTTP请求报文 ---")
        print(http_request_str)
        print("--- 请求报文结束 ---\n")

        # 构造一个简单的HTTP响应,防止浏览器长时间等待
        response_body = "<h1>请求已接收!</h1><p>感谢您的访问。</p>"
        response_headers = [
            "HTTP/1.1 200 OK",
            "Content-Type: text/html; charset=utf-8",
            f"Content-Length: {len(response_body.encode('utf-8'))}",
            "Connection: close", # 响应后关闭连接
            "\r\n" # 空行分隔头部和主体
        ]
        http_response = "\r\n".join(response_headers) + response_body
        client_conn.sendall(http_response.encode('utf-8'))

    except UnicodeDecodeError:
        print("未能解码请求数据,可能包含非UTF-8字符或二进制内容。")
        client_conn.sendall(b"HTTP/1.1 400 Bad Request\r\nConnection: close\r\n\r\nBad Request: Could not decode request.")
    except Exception as e:
        print(f"处理请求时发生错误: {e}")
    finally:
        client_conn.close() # 关闭客户端连接
运行上述代码后,在浏览器中访问`http://127.0.0.1:8000`,服务器的控制台就会打印出详细的HTTP请求报文。
使用Python Requests模块发送带请求体的请求
以下代码展示如何使用`requests`库向上述服务器发送一个POST请求,并携带JSON格式的数据:
import requests
import json # 导入json模块用于打印请求体

# 目标服务器URL
target_server_url = 'http://127.0.0.1:8000' # 与socket服务器的端口保持一致

# 待发送的JSON数据
post_data = {
    'product_id': 'abc12345',
    'quantity': 5,
    'customer_name': 'Zhang San'
}

print(f"正在向 {target_server_url} 发送POST请求,数据: {json.dumps(post_data)}")

try:
    # 发送POST请求,json参数会自动设置Content-Type为application/json
    response = requests.post(target_server_url, json=post_data, timeout=10) # 设置超时

    print(f"服务器响应状态码: {response.status_code}")
    print("服务器响应内容:")
    print(response.text)

except requests.exceptions.ConnectionError:
    print("错误:无法连接到服务器。请确保服务器已运行并监听指定端口。")
except requests.exceptions.Timeout:
    print("错误:请求超时。")
except requests.exceptions.RequestException as e:
    print(f"发生其他请求错误: {e}")
HTTP请求方法概述
HTTP定义了一系列请求方法(或称谓词),它们指示了对特定资源期望执行的操作,可根据其对资源状态的影响分为:
安全方法(Safe Methods)
不会对服务器上的资源产生任何修改:
- GET:从服务器请求获取资源。
- HEAD:与GET类似,但服务器只返回响应头,不返回响应体,用于获取资源的元数据。
幂等方法(Idempotent Methods)
多次执行相同的请求,对服务器资源状态的影响与一次执行相同:
- GET / HEAD:天生幂等。
- PUT:将请求中的资源实体上传到指定URI。如果URI已存在,则替换;如果不存在,则创建。
- DELETE:删除指定URI标识的资源。
- OPTIONS:用于获取目标资源所支持的通信选项。
不安全方法(Unsafe Methods)
每次执行请求都可能导致服务器资源状态的不同变化:
- POST:向服务器提交数据以创建新资源,或对现有资源执行操作。每次提交可能会创建多个资源。
- PATCH:对资源进行部分修改。
- TRACE:用于执行一个应用层的请求消息回路测试。
补充:`\r\n` 回车换行符
在HTTP协议中,请求头与请求体之间必须由一个空行(即连续的两个`\r\n`)分隔。`\r\n`是回车符(Carriage Return, `\r`)和换行符(Line Feed, `\n`)的组合,源于早期电传打字机将打印头移至行首并换到下一行的操作。在HTTP中,这个空行明确地标志着头部信息的结束和请求体内容的开始,使得服务器能够正确解析报文。
4.2 响应报文
服务器向客户端返回的HTTP响应报文通常包含以下部分:
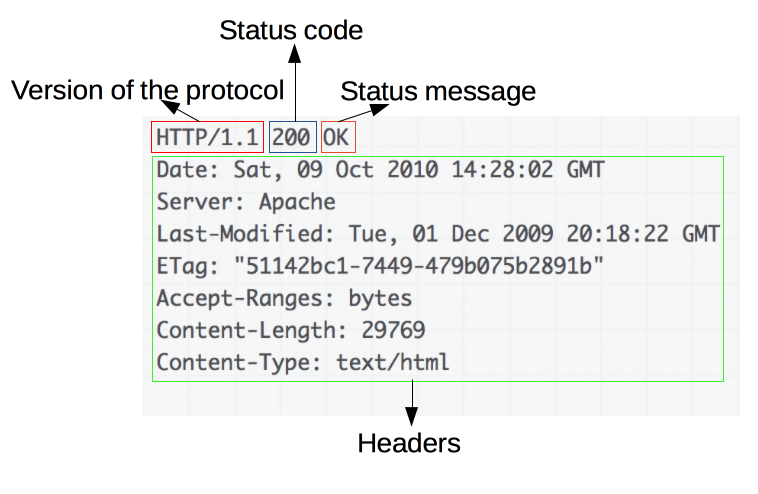
HTTP/1.1 200 OK
Date: Mon, 25 Feb 2024 12:00:00 GMT
Content-Type: text/html; charset=utf-8
Content-Length: 1234
Server: Apache/2.4.41 (Ubuntu)
Connection: keep-alive

<!DOCTYPE html>
<html>
<head><title>Example Page</title></head>
<body>
    <h1>Welcome to the Web!</h1>
    <p>This is an example HTML page.</p>
</body>
</html>
其中主要组成部分有:
- 状态行(Status Line):
- HTTP协议版本:如HTTP/1.1。
- 状态码(Status Code):三位数字,表示请求处理结果的成功或失败。
- 状态信息(Reason Phrase):对状态码的简短英文描述,如"OK"、"Not Found"。
- 响应头(Response Headers):一系列键值对,提供关于服务器、响应数据或缓存策略的额外信息,如`Content-Type`、`Content-Length`、`Server`等。
- 空行:同样用于分隔响应头和响应体。
- 响应体(Response Body):包含服务器返回的实际数据,如HTML内容、图片二进制数据、JSON数据等。
在浏览器开发者工具中查看响应报文
在大多数现代浏览器中,可以通过按下F12键打开开发者工具。导航到"网络"(Network)选项卡,刷新页面,然后点击左侧的某个请求,在右侧的"标头"(Headers)或"响应"(Response)标签页中,可以详细查看该请求的响应报文头部和主体。
常见的HTTP状态码
状态码是服务器向客户端传递请求处理结果的重要信息,分为以下几类:
| 状态码类型 |
描述 |
| 1xx (信息) |
表示请求已被接收,正在进行进一步处理。 |
| 2xx (成功) |
表示请求已成功被接收、理解、接受。 |
| 3xx (重定向) |
客户端需要采取进一步操作才能完成请求。 |
| 4xx (客户端错误) |
客户端发送的请求有误或无法被服务器处理。 |
| 5xx (服务器错误) |
服务器在处理请求时发生了内部错误。 |
以下是一些具体的常见HTTP状态码及其含义:
| 状态码 |
响应信息 |
描述 |
| 200 |
OK |
请求成功,服务器已成功处理请求并返回所需数据。 |
| 201 |
Created |
请求成功,并在服务器上创建了新资源(通常是POST或PUT请求的结果)。 |
| 204 |
No Content |
请求成功,但服务器不返回任何内容。常用于DELETE操作。 |
| 301 |
Moved Permanently |
资源已永久移动到新的URI。客户端应更新其链接。 |
| 302 |
Found |
资源临时移动到新的URI。客户端应继续使用原有URI。 |
| 304 |
Not Modified |
请求的资源未被修改。客户端可以使用本地缓存的版本。 |
| 400 |
Bad Request |
客户端请求的语法错误,服务器无法理解。 |
| 401 |
Unauthorized |
请求需要用户身份验证。 |
| 403 |
Forbidden |
服务器已理解请求,但拒绝执行。通常是权限不足。 |
| 404 |
Not Found |
服务器无法找到请求的资源。常见的错误。 |
| 405 |
Method Not Allowed |
请求行中指定的方法不被请求URI标识的资源所允许。 |
| 500 |
Internal Server Error |
服务器遇到了一个预期之外的错误。 |
| 502 |
Bad Gateway |
作为网关或代理的服务器从上游服务器收到无效响应。 |
| 503 |
Service Unavailable |
服务器暂时无法处理请求,通常是由于过载或维护。 |
| 504 |
Gateway Timeout |
作为网关或代理的服务器在等待上游服务器响应时超时。 |
常见的HTTP响应头参数
响应头提供关于响应数据、服务器信息、缓存控制等辅助信息:
| 选项 |
描述 |
| Content-Type |
告知客户端响应体的MIME类型(媒体类型),如`text/html`、`application/json`。 |
| Content-Length |
告知客户端响应体内容的字节长度。 |
| Content-Encoding |
告知客户端响应数据所使用的编码方式,如`gzip`。 |
| Server |
指明处理请求的Web服务器软件信息。 |
| Date |
生成响应的日期和时间(GMT格式)。 |
| Location |
用于3xx重定向,指定客户端应跳转到的新URI。 |
| Cache-Control |
指定响应的缓存机制,如`max-age`、`no-cache`。 |
| Connection |
指定在完成请求/响应后,客户端与服务器的连接是否保持打开。 |
| Expires |
指定响应的过期时间(绝对时间)。 |
| Access-Control-Allow-Origin |
CORS策略,指明哪些源可以访问该资源。 |
| Content-Disposition |
用于指示资源的预期显示方式,如作为附件下载(`attachment; filename="file.zip"`)。 |
补充:浏览器如何处理不同响应类型(MIME Type)
浏览器依据`Content-Type`响应头来判断接收到的数据类型,并采取相应的处理方式。例如,`Content-Type: text/html`表示HTML文档,浏览器会渲染它;`image/jpeg`则会按图片显示。URL的后缀名(如.jpg)仅是约定,并非决定性因素,`Content-Type`才是浏览器识别资源类型的关键。
常见的浏览器响应MIME类型:
- `text/html`:HTML文档
- `text/css`:CSS样式表
- `application/javascript`:JavaScript脚本
- `image/png`, `image/jpeg`, `image/gif`:各种图片格式
- `application/json`:JSON格式数据
- `text/plain`:纯文本
- `application/pdf`:PDF文档
- `application/octet-stream`:未知二进制流(通常用于文件下载)
- `audio/mpeg`, `video/mp4`:音频和视频文件
5. URL:统一资源定位符
URL(Uniform Resource Locator)是互联网上资源的唯一地址,它不仅指明了资源的位置,也指示了访问该资源所应遵循的协议。
5.1 URL的构成要素
一个完整的URL通常由以下几个部分组成:
- 协议(Protocol):指定访问资源所使用的协议,如`http`、`https`、`ftp`。
- 主机名(Host):资源所在的服务器的域名(如`www.example.com`)或IP地址。
- 端口号(Port):可选。服务器上监听连接的端口。如果省略,则使用协议的默认端口(HTTP默认为80,HTTPS默认为443)。
- 路径(Path):资源在服务器上的具体位置,以斜杠`/`分隔目录和文件。
- 查询参数(Query Parameters):可选。以问号`?`开始,用于向服务器传递额外数据,多个参数间用`&`符号连接,形如`key=value`。
- 片段标识符(Fragment Identifier):可选。以井号`#`开始,用于指定资源中的某个特定部分或锚点。这部分信息不会发送到服务器,仅由浏览器在客户端处理。
5.2 URL示例分析
考虑以下通用URL结构:
https://www.example.com:8080/path/to/resource?queryParam1=value1&queryParam2=value2#section-id
各部分对应关系:
- 协议:`https`
- 主机名:`www.example.com`
- 端口号:`8080`
- 路径:`/path/to/resource`
- 查询参数:`queryParam1=value1&queryParam2=value2`
- 片段标识符:`section-id`
再以百度搜索URL为例:
https://www.baidu.com/s?wd=python&rsv_spt=1&ie=utf-8&tn=baiduhome_pg
- 协议:`https`
- 主机名:`www.baidu.com`
- 路径:`/s`
- 查询参数:
- `wd=python` (搜索关键词)
- `rsv_spt=1` (搜索类型相关参数)
- `ie=utf-8` (编码方式)
- `tn=baiduhome_pg` (来源或工具类型)
