ESP32 SPI从设备10MHz通信速率实测与优化
实测数据表现
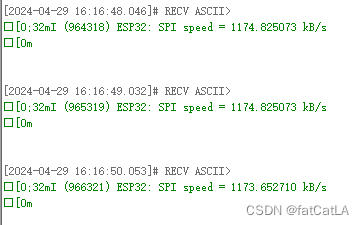
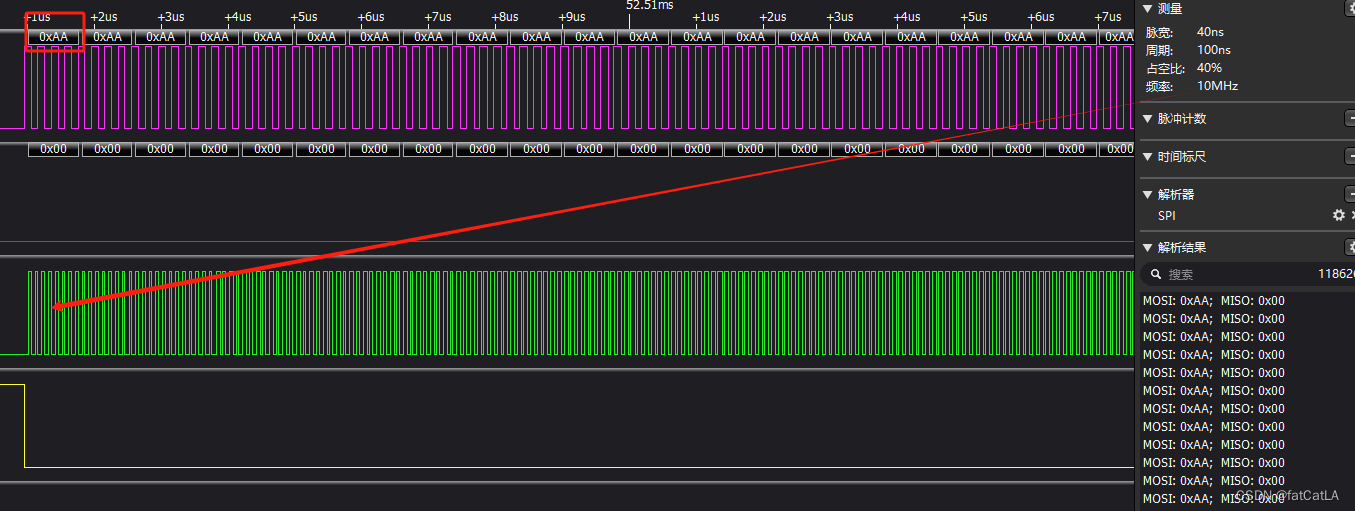
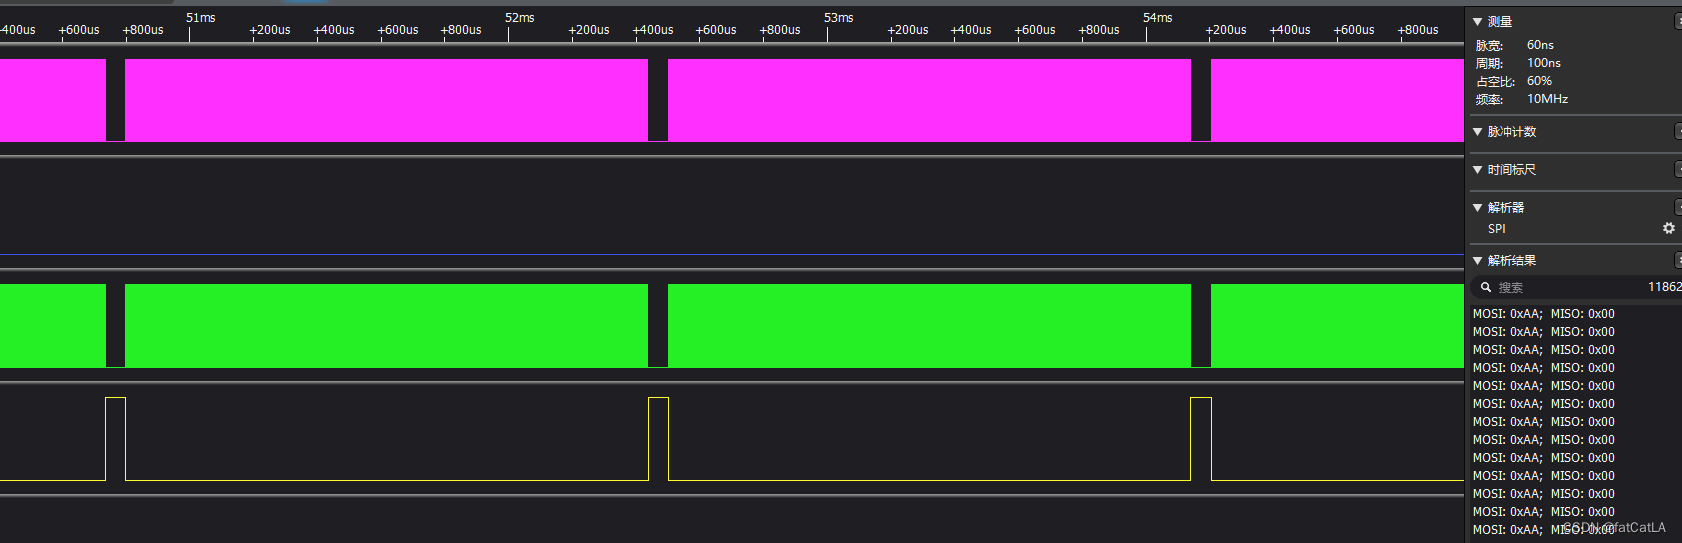
在嵌入式高速数据交互场景中,SPI总线常被用作主控与外设之间的高吞吐通道。本文基于ESP-IDF 5.1框架,对ESP32作为SPI从设备的极限传输性能进行压测。通过底层优化与规范连线,实际测得接收速率约为1174 KB/s,已非常逼近10MHz时钟、8位数据位宽下的理论峰值(1.25 MB/s)。测试过程中的速率统计与逻辑分析仪波形如下:
主机端(Master)架构与实现
主机节点负责发起总线事务。核心配置需将SPI时钟锁定至10MHz,并配置GPIO上升沿中断用于捕获从设备的就绪握手信号。以下为重构后的主机核心逻辑:
#include <stdio.h>
#include <stdint.h>
#include <string.h>
#include "esp_log.h"
#include "freertos/FreeRTOS.h"
#include "freertos/semphr.h"
#include "driver/spi_master.h"
#include "driver/gpio.h"
#include "esp_timer.h"

#define PIN_HSHK      2
#define PIN_SPI_MOSI  12
#define PIN_SPI_MISO  13
#define PIN_SPI_CLK   15
#define PIN_SPI_CS    14
#define HOST_MASTER   SPI2_HOST
#define TX_LEN        2048

static SemaphoreHandle_t slave_rdy_sem;
static uint32_t last_irq_tick;

static void IRAM_ATTR hshk_intr_handler(void *arg) {
    uint32_t now = esp_timer_get_time();
    if (now - last_irq_tick < 1000) return; // 1ms硬件消抖
    last_irq_tick = now;
    BaseType_t xHigherPriorityTaskWoken = pdFALSE;
    xSemaphoreGiveFromISR(slave_rdy_sem, &xHigherPriorityTaskWoken);
    if (xHigherPriorityTaskWoken) portYIELD_FROM_ISR();
}

void app_main(void) {
    spi_device_handle_t dev_hdl;
    spi_bus_config_t bus_cfg = {
        .mosi_io_num = PIN_SPI_MOSI, .miso_io_num = PIN_SPI_MISO,
        .sclk_io_num = PIN_SPI_CLK, .quadwp_io_num = -1, .quadhd_io_num = -1
    };
    spi_device_interface_config_t dev_cfg = {
        .clock_speed_hz = 10000000, .mode = 0, .spics_io_num = PIN_SPI_CS,
        .cs_ena_posttrans = 3, .queue_size = 3, .command_bits = 0,
        .address_bits = 0, .dummy_bits = 0, .duty_cycle_pos = 128
    };

    gpio_config_t hshk_cfg = {
        .pin_bit_mask = (1ULL << PIN_HSHK), .mode = GPIO_MODE_INPUT,
        .pull_up_en = GPIO_PULLUP_ENABLE, .intr_type = GPIO_INTR_POSEDGE
    };

    WORD_ALIGNED_ATTR uint8_t *tx_data = heap_caps_malloc(TX_LEN, MALLOC_CAP_DMA);
    WORD_ALIGNED_ATTR uint8_t *rx_data = heap_caps_malloc(TX_LEN, MALLOC_CAP_DMA);
    memset(tx_data, 0xAA, TX_LEN);

    slave_rdy_sem = xSemaphoreCreateBinary();
    xSemaphoreGive(slave_rdy_sem); // 初始置位,防止从机先启动
    gpio_config(&hshk_cfg);
    gpio_install_isr_service(0);
    gpio_isr_handler_add(PIN_HSHK, hshk_intr_handler, NULL);

    ESP_ERROR_CHECK(spi_bus_initialize(HOST_MASTER, &bus_cfg, SPI_DMA_CH_AUTO));
    ESP_ERROR_CHECK(spi_bus_add_device(HOST_MASTER, &dev_cfg, &dev_hdl));

    spi_transaction_t txn = { .length = TX_LEN * 8, .tx_buffer = tx_data, .rx_buffer = rx_data };

    ESP_LOGI("MAIN", "Master loop started @ 10MHz");
    while (1) {
        xSemaphoreTake(slave_rdy_sem, portMAX_DELAY);
        ESP_ERROR_CHECK(spi_device_transmit(dev_hdl, &txn));
    }
}
主机代码主要调整了引脚宏定义与中断消抖策略。通过记录微秒级时间戳过滤毛刺,确保握手机制不会因信号 ringing 产生误触发。数据缓冲区强制使用DMA对齐分配,避免Cache一致性导致的事务校验失败。
从机端(Slave)回调优化与吞吐量统计
在高速SPI通信中,从设备回调函数的执行延迟会直接拉长主机等待窗口。官方示例依赖GPIO库函数进行引脚电平翻转,函数调用栈与参数校验会引入数微秒的额外开销。本方案改为直接操作外设寄存器,将握手响应时间压缩至纳秒级,并基于高精度定时器实现实时吞吐量计算。
#include <stdio.h>
#include <stdint.h>
#include <string.h>
#include "esp_log.h"
#include "freertos/FreeRTOS.h"
#include "freertos/task.h"
#include "driver/spi_slave.h"
#include "driver/gpio.h"
#include "esp_timer.h"
#include "soc/gpio_reg.h"

#if CONFIG_IDF_TARGET_ESP32
#define PIN_HSHK      2
#define PIN_SPI_MOSI  12
#define PIN_SPI_MISO  13
#define PIN_SPI_CLK   15
#define PIN_SPI_CS    14
#define HOST_SLAVE    HSPI_HOST
#elif CONFIG_IDF_TARGET_ESP32C3 || CONFIG_IDF_TARGET_ESP32S3
#define PIN_HSHK      2
#define PIN_SPI_MOSI  11
#define PIN_SPI_MISO  13
#define PIN_SPI_CLK   12
#define PIN_SPI_CS    10
#define HOST_SLAVE    SPI2_HOST
#endif

#define REG_GPIO_SET  (*(volatile uint32_t *)GPIO_OUT_W1TS_REG)
#define REG_GPIO_CLR  (*(volatile uint32_t *)GPIO_OUT_W1TC_REG)
#define HSHK_BIT_MASK (1U << PIN_HSHK)
#define RX_LEN        2048

void IRAM_ATTR on_xfer_ready(spi_slave_transaction_t *trans) {
    REG_GPIO_SET |= HSHK_BIT_MASK; // 寄存器直写置高
}

void IRAM_ATTR on_xfer_done(spi_slave_transaction_t *trans) {
    REG_GPIO_CLR |= HSHK_BIT_MASK; // 寄存器直写拉低
}

void app_main(void) {
    spi_bus_config_t bus_cfg = {
        .mosi_io_num = PIN_SPI_MOSI, .miso_io_num = PIN_SPI_MISO,
        .sclk_io_num = PIN_SPI_CLK, .quadwp_io_num = -1, .quadhd_io_num = -1
    };
    spi_slave_interface_config_t slave_cfg = {
        .mode = 0, .spics_io_num = PIN_SPI_CS, .queue_size = 3,
        .post_setup_cb = on_xfer_ready, .post_trans_cb = on_xfer_done
    };

    gpio_config_t io_cfg = {
        .pin_bit_mask = (1ULL << PIN_HSHK), .mode = GPIO_MODE_OUTPUT,
        .pull_up_en = GPIO_PULLUP_DISABLE, .pull_down_en = GPIO_PULLDOWN_DISABLE
    };
    gpio_config(&io_cfg);
    gpio_set_pull_mode(PIN_SPI_MOSI, GPIO_PULLUP_ONLY);
    gpio_set_pull_mode(PIN_SPI_CLK, GPIO_PULLUP_ONLY);
    gpio_set_pull_mode(PIN_SPI_CS, GPIO_PULLUP_ONLY);

    ESP_ERROR_CHECK(spi_slave_initialize(HOST_SLAVE, &bus_cfg, &slave_cfg, SPI_DMA_CH_AUTO));

    WORD_ALIGNED_ATTR uint8_t *rx_buf = heap_caps_malloc(RX_LEN, MALLOC_CAP_DMA);
    WORD_ALIGNED_ATTR uint8_t *tx_buf = heap_caps_malloc(RX_LEN, MALLOC_CAP_DMA);
    memset(rx_buf, 0, RX_LEN);
    memset(tx_buf, 0x55, RX_LEN);

    spi_slave_transaction_t txn = { .length = RX_LEN * 8, .tx_buffer = tx_buf, .rx_buffer = rx_buf };

    uint32_t total_bytes = 0;
    int64_t start_us = esp_timer_get_time();

    ESP_LOGI("SLAVE", "Ready to receive @ 10MHz");
    while (1) {
        esp_err_t ret = spi_slave_transmit(HOST_SLAVE, &txn, portMAX_DELAY);
        if (ret == ESP_OK) {
            total_bytes += txn.trans_len / 8;
        }

        int64_t curr_us = esp_timer_get_time();
        if (curr_us - start_us >= 1000000) { // 1秒窗口统计
            float rate_kbps = ((float)total_bytes) / 1024.0f;
            ESP_LOGI("SLAVE", "Throughput: %.2f KB/s", rate_kbps);
            total_bytes = 0;
            start_us = curr_us;
        }
    }
}
从机逻辑重点重构了事务前后置回调。通过直接操作`GPIO_OUT_W1TS`与`GPIO_OUT_W1TC`写1置位/清除寄存器,彻底绕过HAL层函数调用开销。速率统计模块改用`esp_timer_get_time()`获取系统高精度微秒计数,每累积1秒数据即动态输出一次KB/s吞吐量,便于实时观测总线有效带宽。
关键实现细节
- 物理层阻抗匹配:10MHz时钟边沿切换迅速,分布参数影响显著。主从设备间必须使用短距离、低阻抗的专用排线连接。普通杜邦线寄生电容过大,极易引发信号过冲与采样误码。
- 内存对齐与DMA约束:ESP32 SPI控制器硬件直接访问内存,缓冲区必须通过`MALLOC_CAP_DMA`标志分配,且结构体需满足四字节对齐要求,否则事务队列将触发非法地址异常。
- 回调函数执行边界:`post_setup_cb`与`post_trans_cb`运行于中断上下文中,严禁调用阻塞型API或格式化打印。若需处理接收数据,应将指针压入队列,交由独立任务解析,以保证总线握手周期不被拉长。
