C语言结构体:从声明、实例化到内存布局与指针操作
C语言结构体:从声明、实例化到内存布局与指针操作
C语言中的结构体(struct)是一种复合数据类型,它允许我们将不同类型的数据项组合成一个单一的实体。结构体在组织复杂数据、实现自定义数据结构如链表、树等场景中扮演着核心角色。本文将深入探讨结构体的定义、变量的创建与初始化、指针操作以及重要的内存对齐概念。
结构体的基本概念
结构体本质上是自定义的数据类型,它由一个或多个成员组成,这些成员可以是C语言中的任何合法数据类型,包括基本类型(如int, char, double)、数组,甚至可以是其他结构体。结构体的各个成员在逻辑上是一个整体,在物理内存上则按照一定的规则进行存储。
结构体的声明与类型定义
1. 完整声明(标签式结构体)
这是最常见的结构体声明方式,它为结构体定义了一个标签(tag),使得我们可以在程序的任何地方使用该标签来声明结构体变量。
struct ProductInfo {
    int productId;           // 商品编号
    char productName[50];    // 商品名称
    double unitPrice;        // 商品单价
};
上述代码定义了一个名为ProductInfo的结构体类型。要创建此类型的变量,可以使用:
struct ProductInfo itemA;
struct ProductInfo itemB;
结构体的定义通常放置在函数外部(全局作用域),以确保其在整个程序中都可见。
2. 使用 typedef 定义类型别名
为了简化结构体类型名的书写,我们常常结合typedef关键字为结构体创建一个别名。这使得类型名更简洁,使用起来更方便。
typedef struct Fruit {
    double weight;
    double pricePerKg;
    char originAddress[25];
} FruitItem; // FruitItem 现在是 struct Fruit 的别名
现在,我们可以直接使用FruitItem来声明变量:
FruitItem myFruit;
FruitItem anotherFruit;
3. 匿名结构体(不完全声明)
匿名结构体是没有标签的结构体。它的特点是必须在定义时直接创建变量。这种结构体类型只能在定义它的位置使用一次,无法在其他地方再次声明同类型的变量。
struct {
    double dimensionX;
    double dimensionY;
    char label[10];
} box1, box2; // 直接创建了两个变量 box1 和 box2
如果声明了两个内容相同的匿名结构体,它们在编译器看来是完全不同的类型,因此不能相互赋值。例如:
#include <stdio.h>

struct {
    char idChar;
    int dataVal;
    char flagChar;
} recordOne;

struct {
    char idChar;
    int dataVal;
    char flagChar;
} recordTwo;

int main() {
    // 尝试将 recordTwo 赋值给 recordOne 将导致编译错误
    // recordOne = recordTwo;
    printf("如果取消注释,recordOne = recordTwo; 将导致编译错误,因为它们是不同类型的匿名结构体。\n");
    return 0;
}
尝试执行recordOne = recordTwo;会导致以下编译错误:
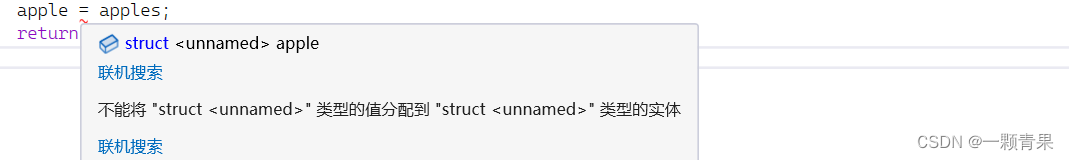
匿名结构体适用于仅需一次性使用的场景,或者当您希望限制该结构体类型不被其他模块复用时。
结构体变量的创建与初始化
结构体变量的初始化有两种主要方式:声明时初始化和声明后逐成员赋值。
1. 声明时初始化
在声明结构体变量的同时,可以使用花括号{}对成员进行初始化。初始化值的顺序必须与结构体成员的声明顺序一致。
typedef struct ItemDetails {
    double itemWeight;
    double itemPrice;
    char itemLocation[20];
} ItemDetails;

int main() {
    ItemDetails myItem = {2.5, 35.0, "WarehouseA"};
    // myItem.itemWeight = 2.5, myItem.itemPrice = 35.0, myItem.itemLocation = "WarehouseA"
    return 0;
}
如果初始化的值少于结构体成员数量,未被初始化的成员将根据其类型自动赋值为0(或空指针等)。
2. 声明后逐成员赋值
如果结构体变量已经声明,或者需要修改其成员值,可以使用成员访问运算符.(点运算符)来单独访问并赋值每个成员。
#include <stdio.h>
#include <string.h> // 用于 strcpy

typedef struct ItemDetails {
    double itemWeight;
    double itemPrice;
    char itemLocation[20];
} ItemDetails;

int main() {
    ItemDetails anotherItem;
    anotherItem.itemWeight = 1.8;
    anotherItem.itemPrice = 28.5;
    // 对于字符数组,需要使用 strcpy 或逐字符赋值
    strcpy(anotherItem.itemLocation, "ShelfB");
    // 如果是逐字符赋值:
    // anotherItem.itemLocation[0] = 'S';
    // anotherItem.itemLocation[1] = 'h';
    // ...
    // anotherItem.itemLocation[6] = '\0';

    printf("商品位置: %s\n", anotherItem.itemLocation);
    return 0;
}
注意,字符数组不能直接通过=运算符进行字符串整体赋值,需要使用strcpy函数(或strncpy,更安全)或逐字符赋值。
结构体指针及其成员访问
结构体指针是C语言中操作结构体的重要方式,尤其是在传递结构体给函数或处理动态内存分配时。
1. 声明与赋值
结构体指针的声明方式与其他类型指针类似,使用*运算符。建议在声明时初始化为NULL以避免野指针。
#include <stdio.h>

typedef struct Point {
    int x;
    int y;
} Point;

int main() {
    Point currentPoint = {10, 20};
    Point *ptrPoint = ¤tPoint; // ptrPoint 指向 currentPoint
    Point *nullPoint = NULL;         // 初始化为 NULL
    return 0;
}
2. 通过 -> 运算符访问成员
当通过结构体指针访问其成员时,可以使用"箭头运算符"->。这是最常用和推荐的方式。
#include <stdio.h>

typedef struct Point {
    int x;
    int y;
} Point;

int main() {
    Point currentPoint;
    Point *ptrPoint = ¤tPoint;

    ptrPoint->x = 30; // 访问并赋值 x 成员
    ptrPoint->y = 40; // 访问并赋值 y 成员

    printf("点坐标: (%d, %d)\n", currentPoint.x, currentPoint.y); // 输出 (30, 40)
    return 0;
}
3. 通过解引用 * 和 . 运算符访问成员
另一种方式是先对指针进行解引用(得到结构体变量本身),然后使用点运算符.访问成员。需要注意的是,解引用运算符*的优先级低于点运算符.,所以必须使用括号()来确保解引用操作先发生。
#include <stdio.h>

typedef struct Point {
    int x;
    int y;
} Point;

int main() {
    Point currentPoint;
    Point *ptrPoint = ¤tPoint;

    (*ptrPoint).x = 50; // 解引用 ptrPoint 得到 currentPoint, 再访问 x
    (*ptrPoint).y = 60; // 解引用 ptrPoint 得到 currentPoint, 再访问 y

    printf("点坐标: (%d, %d)\n", currentPoint.x, currentPoint.y); // 输出 (50, 60)
    return 0;
}
这两种访问方式效果相同,但->运算符更简洁直观。
结构体数组与指针操作
结构体数组是同类型结构体变量的集合,如同基本数据类型的数组。指针也可以用于遍历和访问结构体数组的元素。
1. 结构体数组的声明与初始化
可以一次性声明并初始化整个结构体数组,也可以逐个元素或逐个成员进行初始化。
#include <stdio.h>
#include <string.h>

typedef struct Book {
    char title[100];
    char author[50];
    double price;
} Book;

int main() {
    // 声明时完整初始化
    Book library[3] = {
        {"The C Programming Language", "Dennis Ritchie", 65.0},
        {"Data Structures in C", "Aaron Tenenbaum", 80.0},
        {"Operating System Concepts", "Silberschatz", 120.0}
    };

    // 声明后逐元素/逐成员赋值
    Book newBooks[2];
    strcpy(newBooks[0].title, "Clean Code");
    strcpy(newBooks[0].author, "Robert C. Martin");
    newBooks[0].price = 95.0;

    // 部分初始化(未赋值的成员自动置零)
    Book partialBooks[2] = {
        {"Effective C", "Robert C. Seacord", 70.0}
        // partialBooks[1] 的所有成员将自动置零
    };

    printf("第一本书名: %s\n", library[0].title);
    return 0;
}
2. 通过指针遍历结构体数组
结构体数组名本身就是一个指向第一个元素的指针。我们可以使用指针算术和->运算符来高效地遍历数组。
#include <stdio.h>
#include <string.h>

typedef struct Student {
    int studentID;
    char studentName[30];
    double score;
} Student;

int main() {
    Student classList[3] = {
        {1001, "Alice", 85.5},
        {1002, "Bob", 92.0},
        {1003, "Charlie", 78.0}
    };

    Student *studentPtr = classList; // studentPtr 指向 classList[0]

    // 访问数组的第二个元素 (索引为1)
    (studentPtr + 1)->studentID = 1004; // 将 Bob 的 ID 改为 1004
    strcpy((studentPtr + 1)->studentName, "Bobby"); // 修改名字
    (studentPtr + 1)->score = 90.0; // 修改分数

    printf("更新后的学生信息 (ID %d): 姓名 %s, 分数 %.1f\n",
           classList[1].studentID, classList[1].studentName, classList[1].score);

    // 遍历并打印所有学生信息
    printf("\n所有学生信息:\n");
    for (int i = 0; i < 3; ++i) {
        printf("ID: %d, 姓名: %s, 分数: %.1f\n",
               (studentPtr + i)->studentID, (studentPtr + i)->studentName, (studentPtr + i)->score);
    }

    return 0;
}
结构体内存对齐
内存对齐是C语言中一个重要的概念,它影响结构体在内存中的存储方式和大小。理解内存对齐有助于优化程序性能和减少内存浪费。
1. sizeof 的差异现象
考虑以下结构体:
typedef struct ComplexData {
    double valueA;
    double valueB;
    char description[20];
} ComplexData;

int main() {
    printf("Size of ComplexData: %zu bytes\n", sizeof(ComplexData));
    return 0;
}
我们可能会预期sizeof(ComplexData)为 8 (double) + 8 (double) + 20 (char array) = 36 字节。然而,在大多数64位系统(如Windows下的Visual Studio,默认8字节对齐)中,实际输出通常是 40 字节。

这就是内存对齐在起作用。
2. 内存对齐规则
为了提高处理器访问内存的效率,编译器会按照一定的规则对结构体成员进行内存布局,这被称为内存对齐。主要的对齐规则如下:
- 首成员对齐: 结构体的第一个成员总是放置在结构体起始地址(偏移量为0)处。
- 成员对齐: 每个成员的起始地址(偏移量)必须是其自身"有效对齐数"的整数倍。有效对齐数是该成员自身大小与编译器默认对齐数(通常是4、8或16字节,在Visual Studio中默认为8字节)的较小值。
- 结构体总大小对齐: 整个结构体的总大小必须是其"最大对齐数"(结构体中所有成员的有效对齐数中的最大值)的整数倍。如果不足,会在末尾填充空白字节。
- 嵌套结构体: 如果结构体中包含另一个结构体,则内部结构体的对齐数是其自身成员中最大有效对齐数。
以ComplexData为例,假设默认对齐数为8字节:
valueA(double, 8字节): 偏移量为0,有效对齐数 min(8, 8) = 8。占据0-7字节。valueB(double, 8字节): 偏移量必须是其有效对齐数8的倍数。放在8-15字节。description(char[20], 20字节): 偏移量必须是其有效对齐数 min(1, 8) = 1 的倍数。可以放在16-35字节。
此时结构体所有成员占据的原始内存总和为36字节。但是,根据规则3,整个结构体的总大小必须是其最大对齐数8的整数倍。36不是8的整数倍,最接近且大于36的8的倍数是40。因此,编译器会在description之后填充4个字节,使结构体总大小变为40字节。
3. 设置默认对齐数:#pragma pack
可以使用#pragma pack(n)指令来修改编译器的默认对齐数,其中n通常是1、2、4、8、16等。这将影响其后定义的结构体的对齐方式。
#include <stdio.h>

#pragma pack(1) // 设置默认对齐数为1字节

typedef struct CompactData {
    char ch1;
    int num;
    char ch2;
} CompactData;

#pragma pack() // 恢复默认对齐数

int main() {
    printf("Size of CompactData with pack(1): %zu bytes\n", sizeof(CompactData));
    // 在 #pragma pack(1) 的作用下,预期输出:1 (ch1) + 4 (num) + 1 (ch2) = 6 字节
    return 0;
}
使用#pragma pack(1)后,CompactData的大小将变为6字节,因为它强制每个成员都按1字节对齐,不再有填充。
4. 内存对齐的原因
内存对齐的存在主要基于以下两点考量:
- 平台兼容性(移植性): 并非所有硬件平台都能访问任意地址上的任意数据。某些处理器只能从特定的地址(如2字节、4字节或8字节的倍数)读取特定类型的数据。如果不遵循这些规则,可能会导致硬件异常或程序崩溃。
- 性能优化: 处理器通常以"字"(word)为单位(例如4字节或8字节)从内存中读取数据。如果数据未对齐,一个数据可能跨越两个内存字的边界,导致处理器需要进行两次内存访问才能完整读取该数据。而对齐的数据只需一次访问即可,显著提升了数据访问效率。
总而言之,结构体的内存对齐是一种"以空间换时间"的策略。
5. 优化结构体成员顺序以节省空间
虽然内存对齐会引入填充字节,但我们可以通过合理安排结构体成员的顺序来尽量减少这种浪费。通常建议将占用内存较小的成员集中放置,或者按大小递增/递减的顺序排列。
#include <stdio.h>

// 结构体 A:成员顺序不佳,可能存在较多填充
struct AlignedExampleA {
    char c1; // 1 byte
    int i1;  // 4 bytes
    char c2; // 1 byte
}; // 在默认8字节对齐下,其大小可能为 1 + (7字节填充) + 4 + 1 + (3字节填充) = 16 字节

// 结构体 B:优化成员顺序,减少填充
struct AlignedExampleB {
    char c1; // 1 byte
    char c2; // 1 byte
    int i1;  // 4 bytes
}; // 在默认8字节对齐下,其大小可能为 1 + 1 + (2字节填充) + 4 = 8 字节

int main() {
    printf("AlignedExampleA 的大小: %zu bytes\n", sizeof(struct AlignedExampleA));
    printf("AlignedExampleB 的大小: %zu bytes\n", sizeof(struct AlignedExampleB));
    return 0;
}
在默认8字节对齐的环境下,AlignedExampleA的大小可能是16字节(取决于编译器和具体实现,但会大于8字节),而AlignedExampleB的大小则可能是8字节。这是因为将两个char成员放在一起,它们可以更紧密地排列,减少了中间的填充,从而节省了内存空间。
实践案例:自动售货机商品管理
为了巩固对结构体应用的理解,我们来看一个自动售货机商品管理的例子。我们将定义一个结构体来表示商品信息,并编写函数来显示商品菜单和处理购买订单。
商品信息结构体定义:
typedef struct ItemDetails {
    int itemId;          // 商品编号
    char itemName[25];   // 商品名称 (略微增加数组大小以容纳更长的名称)
    double unitPrice;    // 商品单价
} ItemDetails;
函数接口定义:
void displayMenu(const ItemDetails items[], int count);
void processOrder(const ItemDetails items[], int count);
- 函数
displayMenu()的功能是按[商品编号] 商品名称 商品单价形式显示菜单,分行输出各商品信息。 - 在函数
processOrder()中,先输入要购买的商品编号以及数量,接着按商品名称 * 数量 = 价格形式输出购买该商品的金额,允许购买多种商品,当输入0时表示所选商品结束,最后输出计算的总价格(保留1位小数)。
主函数框架与实现:
#include <stdio.h>
#include <string.h> // For strcpy or input

// 商品信息结构体定义
typedef struct ItemDetails {
    int itemId;
    char itemName[25];
    double unitPrice;
} ItemDetails;

// 函数声明
void displayMenu(const ItemDetails items[], int count);
void processOrder(const ItemDetails items[], int count);

int main() {
    ItemDetails stockItems[20]; // 最多可有20个商品
    int itemCount;

    // 1. 读取商品数量
    scanf("%d", &itemCount);

    // 2. 循环读取各商品的编号、名称和单价
    for (int i = 0; i < itemCount; ++i) {
        scanf("%d %s %lf", &stockItems[i].itemId, stockItems[i].itemName, &stockItems[i].unitPrice);
    }

    // 3. 调用 displayMenu() 函数显示商品菜单
    displayMenu(stockItems, itemCount);

    // 4. 调用 processOrder() 函数处理订单
    processOrder(stockItems, itemCount);

    return 0;
}

// 函数实现:显示商品菜单
void displayMenu(const ItemDetails items[], int count) {
    for (int i = 0; i < count; ++i) {
        printf("[%d] %s %.1f\n", items[i].itemId, items[i].itemName, items[i].unitPrice);
    }
}

// 函数实现:处理购买订单
void processOrder(const ItemDetails items[], int count) {
    int purchasedId, purchasedQuantity;
    double totalTransactionCost = 0.0; // 记录总购买金额

    while (scanf("%d", &purchasedId) == 1 && purchasedId != 0) {
        scanf("%d", &purchasedQuantity);
        for (int i = 0; i < count; ++i) {
            if (items[i].itemId == purchasedId) {
                double currentItemCost = items[i].unitPrice * purchasedQuantity;
                printf("%s * %d = %.1f\n", items[i].itemName, purchasedQuantity, currentItemCost);
                totalTransactionCost += currentItemCost;
                break; // 找到商品并处理完毕,跳出内部循环
            }
        }
    }
    printf("Total = %.1f\n", totalTransactionCost);
}
输入样例:
3
1001 Water 2.0
1002 OrangeJuice 3.5
1003 GreenTea 3.0
1001 2
1003 1
0
输出样例:
[1001] Water 2.0
[1002] OrangeJuice 3.5
[1003] GreenTea 3.0
Water * 2 = 4.0
GreenTea * 1 = 3.0
Total = 7.0
