深度融合 Matchering:加速专业音频制作与母带处理
基础应用:快速实现母带处理
Matchering 作为一款开源的音频匹配与母带处理工具,为音乐制作人提供了一种高效实现专业级音频后期处理的途径。Matchering 提供了简洁明了的编程接口,即使是不具备深厚编程背景的用户也能迅速上手。以下示例展示了其核心功能,仅需数行代码即可完成音频的母带匹配处理:
import matchering as mg
import os

# 配置日志输出,方便跟踪处理进度
mg.log(print)

# 定义输入文件路径和参考文件路径
input_track_path = "source_material.wav"
reference_mix_path = "professional_reference.wav"
output_master_path = "final_master_16bit.wav"

# 确保输入文件存在 (这里只是演示,实际应用中需要更严谨的路径检查)
if not os.path.exists(input_track_path) or not os.path.exists(reference_mix_path):
    print("错误:源文件或参考文件不存在。请检查路径。")
else:
    # 执行音频处理过程
    # target: 待处理的音频文件,其特性将与参考文件匹配
    # reference: 用于提供目标频谱和动态特征的参考音频
    # results: 定义输出格式和路径列表。mg.pcm16 表示输出16位PCM WAV文件
    mg.process(
        target=input_track_path,
        reference=reference_mix_path,
        results=[mg.pcm16(output_master_path)]
    )
    print(f"母带处理完成,输出文件:{output_master_path}")
这段代码的核心在于将目标音频文件的频谱特性和动态范围与指定的参考音轨进行匹配,并自动生成经过母带处理的输出文件。通过修改文件路径,用户可以轻松将其融入到自己的制作环节。
视觉化分析:直观评估音频特性
Matchering 内置的专业频谱分析功能,使用户能够清晰地观察音频在处理前后的变化。通过对比不同处理模式下的频谱图,制作人可以精确地调整参数,以达到预期的声音效果。
经过硬剪辑处理的音频频谱,高频区域可能出现失真迹象。
软剪辑处理后的频谱图,声音动态范围表现更为自然。
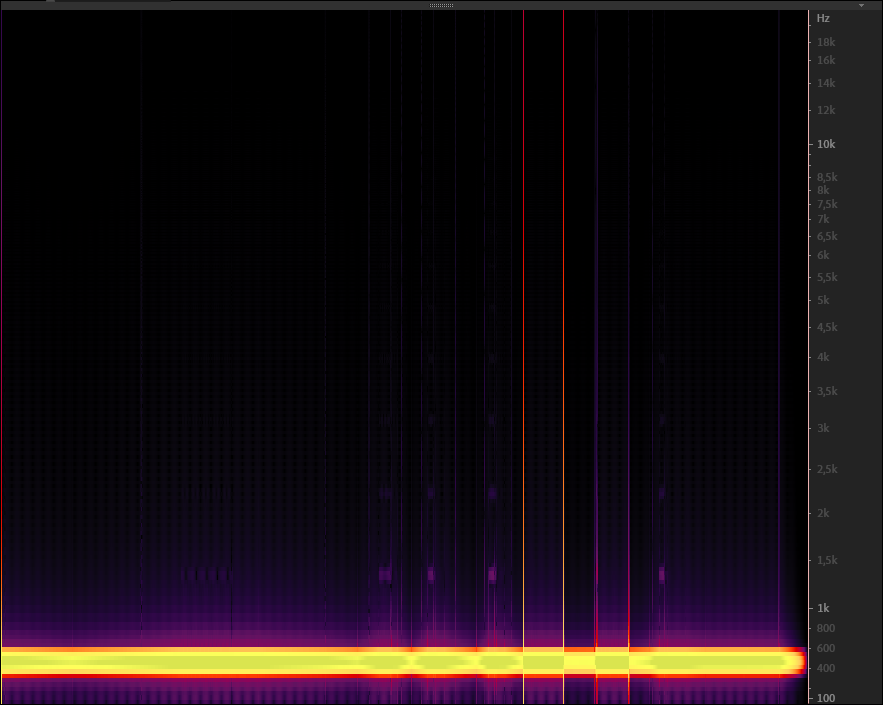 Matchering 算法优化后的频谱示例,在保持丰富细节的同时有效控制动态。
这些可视化工具能够帮助用户在音频处理过程中实时监测声音变化,确保每一步调整都符合创作意图。
跨平台部署:Docker容器化方案
为了解决不同操作系统下的依赖冲突和环境配置难题,Matchering 提供了完善的 Docker 支持。通过容器化部署,用户可以在任何兼容 Docker 的环境中快速启动 Matchering 服务,无需担忧系统兼容性问题。
Docker 桌面版示意图,通常只需简单操作即可部署服务。
典型的 Docker 部署与运行指令:
# 首先克隆 Matchering 项目仓库
git clone https://gitcode.com/gh_mirrors/ma/matchering
cd matchering

# 构建 Docker 镜像,命名为 'matchering-env'
docker build -t matchering-env .

# 运行 Docker 容器,并挂载本地输入/输出目录
# 'source_audio' 目录存放待处理文件
# 'output_results' 目录用于保存处理结果
docker run -v $(pwd)/source_audio:/app/input -v $(pwd)/output_results:/app/output matchering-env
这种部署方式特别适用于团队协作,确保所有成员在统一的处理环境下工作,从而避免因环境差异导致的结果不一致。
批量处理:提升多文件工作效率
对于需要处理大量音轨或专辑内容的场景,Matchering 能够通过编写简单脚本实现自动化批量处理。用户可以结合其高级配置选项,构建自定义的自动化工作流程。
import matchering as mg
import os

mg.log(print)

# 定义输入音频文件所在的目录
source_folder = "album_tracks_to_process"
# 定义处理结果的输出目录
processed_output_folder = "mastered_album_final"
# 指定用于批量处理的参考音轨
batch_reference_track = "album_reference.wav"

# 确保输出目录存在,如果不存在则创建
os.makedirs(processed_output_folder, exist_ok=True)

print(f"开始批量处理 '{source_folder}' 目录下的音频文件...")

# 遍历输入目录中的所有 WAV 或 FLAC 文件
for filename in os.listdir(source_folder):
    if filename.lower().endswith(('.wav', '.flac')):
        current_target_path = os.path.join(source_folder, filename)
        # 为每个文件生成一个独特的输出文件名
        output_file_name = f"mastered_{filename}"
        current_output_path = os.path.join(processed_output_folder, output_file_name)

        print(f"正在处理:'{filename}' -> '{output_file_name}'")
        try:
            mg.process(
                target=current_target_path,
                reference=batch_reference_track,
                results=[mg.pcm24(current_output_path)] # 输出为24位PCM格式
            )
            print(f"处理完成:'{current_output_path}'")
        except Exception as e:
            print(f"处理 '{filename}' 时发生错误:{e}")
    else:
        print(f"跳过非WAV/FLAC文件:'{filename}'")

print("所有指定文件已批量处理完毕。")
此脚本能够自动处理指定目录下的所有兼容音频文件,并将母带处理后的结果保存至预设的输出目录,极大减轻了重复性操作的负担,让制作人能更专注于创意本身。
精准控制动态范围:实现专业级响度平衡
Matchering 的核心优势之一在于其先进的动态范围控制算法。通过内部模块,用户可以精确调整音频的动态表现,使其既能保留音乐的艺术张力,又能符合当前流媒体平台的响度规范。
Matchering 处理前后音频波形对比,展示动态范围的优化效果。
通过 API 进行动态范围参数设置的示例:
import matchering as mg

mg.log(print)

# 定义输入、参考和输出文件路径
input_song = "my_original_mix.wav"
reference_song = "target_genre_loudness.wav"
output_master_file = "mastered_with_dr_control.wav"

print(f"开始处理 '{input_song}',并调整响度与动态范围...")

# 执行处理,并自定义响度与动态范围参数
# loudness_target: 设定目标响度级别(例如,Loudness Units Full Scale - LUFS)
# dynamic_range_strength: 控制动态范围的程度,数值越大动态压缩越少
mg.process(
    target=input_song,
    reference=reference_song,
    loudness_target=-10.0,            # 设定目标响度为 -10 LUFS
    dynamic_range_strength=10.0,      # 设定动态范围强度,保留更多动态
    results=[mg.pcm16(output_master_file)]
)

print(f"音频已处理并输出至:'{output_master_file}',响度与动态范围已成功调整。")
通过调整这些参数,无论是需要强劲冲击力的电子音乐,还是注重细腻情感表达的古典乐,都能获得最佳的播放效果,确保作品在各种播放设备上听感一致且饱满。