基于YOLOv11的智能安全帽佩戴检测系统构建实践
随着城市化进程的不断加快,建筑行业作为国民经济的重要支柱,其安全生产问题日益受到社会各界的关注。统计数据显示,建筑工地事故中,约有23%与头部防护措施的缺失直接相关。安全帽作为建筑工人最基本的个人防护装备,其规范佩戴是预防伤害、降低事故风险的关键。然而,传统的人工巡检方式效率低下、成本高昂,且难以实现全天候、无死角的实时监控。
为应对这一挑战,结合计算机视觉与人工智能技术,智能安全帽佩戴检测系统应运而生,为工地安全管理提供了创新的解决方案。
系统技术价值与行业意义
技术应用核心价值
基于智能摄像头和深度学习算法的建筑工地安全帽识别系统,能够实现以下核心功能:
- 实时监测预警: 系统能够以毫秒级速度识别未佩戴安全帽的人员,并立即触发告警。
- 行为轨迹分析: 结合人员位置数据,追踪高风险区域的违规行为模式,为管理提供数据支撑。
- 数据可视化: 自动生成安全合规热力图及各类统计报告,直观展现安全状况。
- 多场景适应性: 在复杂光照、部分遮挡以及多角度视角等挑战性条件下,依然能保持高精度识别。
这项技术将传统的被动式安全管理模式转变为主动预防机制,将事故预防窗口前移至"事中干预",显著提升了工地安全管理的效能。根据已部署项目的试点数据,系统实施后,违规佩戴率显著下降,相关事故发生率也有明显降低。
对行业发展的推动作用
从更宏观的层面来看,安全帽识别技术的广泛应用具有三重战略价值:
- 人员安全保障升级: 通过技术手段强化"最后一公里"的防护执行,切实保障建筑工人生命安全,体现"以人为本"的行业发展理念。
- 管理效能革新: 有效降低安全管理成本,同时提升监管的透明度和及时性,助力建筑企业实现数字化转型与智能化升级。
- 行业标准重塑: 推动《智慧工地建设评价标准》(GB/T51435-2021)等国家标准的落地实施,为建筑行业的智能化发展提供技术范本和实践经验。
YOLOv11安全帽检测项目实战
环境准备与依赖库导入
在开始项目之前,我们需要确保开发环境中安装了必要的依赖库。通常,这包括PyTorch、Ultralytics YOLO库、OpenCV、PIL以及用于数据处理和可视化的其他工具。首先,验证PyTorch和CUDA环境是否正常:
import torch

# 检查CUDA(GPU)是否可用
print(f"CUDA是否可用: {torch.cuda.is_available()}")
# 打印PyTorch版本
print(f"PyTorch版本: {torch.__version__}")
接着,导入本教程可能用到的其他关键库:
import warnings
import random
import os
import shutil
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import cv2
import yaml
from PIL import Image
from ultralytics import YOLO # 用于YOLO模型的训练和推理
from IPython.display import Video # 如果需要展示视频检测结果
warnings.filterwarnings('ignore') # 忽略警告信息
数据集加载与初步分析
本项目使用YOLO格式的数据集,包含图像文件及其对应的标签文件。首先,我们加载数据集的配置文件(通常为data.yaml),其中定义了数据集的路径、类别名称等信息。
# 假设数据集根目录位于当前工作目录下的 'dataset' 文件夹
# 实际项目中请根据您的数据存储路径进行调整
DATA_ROOT = 'dataset'
CONFIG_FILE_PATH = os.path.join(DATA_ROOT, 'data.yaml')

print(f"正在加载数据集配置文件: {CONFIG_FILE_PATH}")
with open(CONFIG_FILE_PATH, 'r', encoding='utf-8') as f:
    config_data = yaml.safe_load(f)
print("\n数据集配置内容:")
print(yaml.dump(config_data, default_flow_style=False, allow_unicode=True))
数据集数量与尺寸统计
了解训练集和验证集中图片的数量及尺寸分布对模型训练至关重要。虽然YOLO模型对输入图片尺寸的统一性没有严格要求,但了解其分布有助于后续的数据增强策略。
# 定义图片目录路径
train_image_directory = os.path.join(DATA_ROOT, 'train', 'images')
validation_image_directory = os.path.join(DATA_ROOT, 'valid', 'images')

# 统计图片数量和尺寸的函数
def get_image_stats(image_folder, dataset_label=""):
    image_counter = 0
    unique_image_dimensions = set()

    if not os.path.exists(image_folder):
        print(f"警告: {dataset_label}图片目录 {image_folder} 不存在。")
        return 0, unique_image_dimensions

    for img_filename in os.listdir(image_folder):
        if img_filename.lower().endswith(('.jpg', '.jpeg', '.png')):
            image_counter += 1
            full_img_path = os.path.join(image_folder, img_filename)
            try:
                with Image.open(full_img_path) as current_img:
                    unique_image_dimensions.add(current_img.size)
            except Exception as e:
                print(f"无法读取图片 {full_img_path}: {e}")
    return image_counter, unique_image_dimensions

num_training_images, training_image_sizes = get_image_stats(train_image_directory, "训练集")
num_validation_images, validation_image_sizes = get_image_stats(validation_image_directory, "验证集")

print(f"\n训练集图片总数: {num_training_images}")
print(f"验证集图片总数: {num_validation_images}")

if len(training_image_sizes) == 1:
    print(f"所有训练图片尺寸统一: {training_image_sizes.pop()}")
else:
    print(f"训练图片尺寸多样,共发现 {len(training_image_sizes)} 种不同尺寸。")

if len(validation_image_sizes) == 1:
    print(f"所有验证图片尺寸统一: {validation_image_sizes.pop()}")
else:
    print(f"验证图片尺寸多样,共发现 {len(validation_image_sizes)} 种不同尺寸。")
标签类别分布统计
为了解数据集中各目标类别的分布情况,我们统计了所有标签文件中每个类别的实例数量。这有助于发现类别不平衡问题,并为后续的数据清洗或增强提供依据。
from collections import Counter
from pathlib import Path

# 用于统计YOLO格式标签文件中的类别数量
def count_yolo_labels(labels_folder_path):
    print(f"正在统计 {labels_folder_path} 目录下的标签...")
    label_tally_counter = Counter()
    label_text_files = list(Path(labels_folder_path).rglob('*.txt'))
    print(f"找到 {len(label_text_files)} 个标签文件。")

    for label_filepath in label_text_files:
        try:
            with open(label_filepath, 'r') as current_file:
                for line_content in current_file:
                    parts = line_content.strip().split()
                    if parts:
                        class_id = int(parts[0])
                        label_tally_counter[class_id] += 1
        except Exception as e:
            print(f"读取标签文件 {label_filepath} 失败: {e}")
    return label_tally_counter

# 重新加载数据集配置文件以获取类别名称映射
with open(CONFIG_FILE_PATH, 'r', encoding='utf-8') as f:
    dataset_configuration = yaml.safe_load(f)
class_names_mapping = dataset_configuration.get('names', [])

# 标签目录路径
train_labels_folder = os.path.join(DATA_ROOT, 'train', 'labels')
val_labels_folder = os.path.join(DATA_ROOT, 'valid', 'labels')

# 统计训练集和验证集标签
train_label_counts = count_yolo_labels(train_labels_folder)
val_label_counts = count_yolo_labels(val_labels_folder)

print("\n各类别标签初步分布:")
print("训练集标签计数:", train_label_counts)
print("验证集标签计数:", val_label_counts)

# 合并所有标签计数以查看总体分布
total_label_counts = train_label_counts + val_label_counts

for cls_id, count_val in sorted(total_label_counts.items()):
    class_name = class_names_mapping[cls_id] if cls_id < len(class_names_mapping) else f"未知类别_{cls_id}"
    print(f"类别 '{class_name}' (ID: {cls_id}) 共有 {count_val} 个实例。")
根据上述统计,我们发现数据集中可能存在类别不平衡现象,例如"person"类别的实例数量显著少于"head"和"helmet"。为了简化模型任务并专注于安全帽检测的核心问题,我们可以选择移除"person"类别,并调整剩余类别的ID。
数据清洗与标签重映射
针对"person"类别样本量过少的问题,我们选择将其从数据集中移除。之后,由于"helmet"类别原ID为2,为了使其ID连续,我们将"helmet"的ID重映射为1。
# 移除特定类别标签的函数
def remove_class_from_labels(labels_dir, class_id_to_remove=1):
    print(f"正在清理 {labels_dir} 目录下的标签文件,移除类别ID {class_id_to_remove}...")
    label_files_list = list(Path(labels_dir).rglob('*.txt'))
    files_modified_count = 0

    for label_file_path in label_files_list:
        original_lines = []
        with open(label_file_path, 'r') as f_read:
            original_lines = f_read.readlines()

        modified_lines = []
        for line_content in original_lines:
            parts = line_content.strip().split()
            if parts and int(parts[0]) != class_id_to_remove:
                modified_lines.append(line_content)

        if len(modified_lines) < len(original_lines):
            files_modified_count += 1
            with open(label_file_path, 'w') as f_write:
                f_write.writelines(modified_lines)
    print(f"在 {labels_dir} 目录下共修改了 {files_modified_count} 个文件。")

# 移除类别ID为1(假设为'person')的所有标签
remove_class_from_labels(os.path.join(DATA_ROOT, 'train', 'labels'), class_id_to_remove=1)
remove_class_from_labels(os.path.join(DATA_ROOT, 'valid', 'labels'), class_id_to_remove=1)

# 重映射类别ID的函数
def remap_label_class_ids(labels_dir, old_class_id=2, new_class_id=1):
    print(f"正在重映射 {labels_dir} 目录下的标签文件: 将类别ID {old_class_id} 修改为 {new_class_id}...")
    label_files_list = list(Path(labels_dir).rglob('*.txt'))
    files_remapped_count = 0

    for label_file_path in label_files_list:
        original_lines = []
        with open(label_file_path, 'r') as f_read:
            original_lines = f_read.readlines()

        modified_lines = []
        file_content_changed = False
        for line_content in original_lines:
            parts = line_content.strip().split()
            if parts and int(parts[0]) == old_class_id:
                modified_lines.append(f"{new_class_id} {' '.join(parts[1:])}\n")
                file_content_changed = True
            else:
                modified_lines.append(line_content)

        if file_content_changed:
            files_remapped_count += 1
            with open(label_file_path, 'w') as f_write:
                f_write.writelines(modified_lines)
    print(f"在 {labels_dir} 目录下共重映射了 {files_remapped_count} 个文件。")

# 将类别ID为2(假设为'helmet')重映射为1
remap_label_class_ids(os.path.join(DATA_ROOT, 'train', 'labels'), old_class_id=2, new_class_id=1)
remap_label_class_ids(os.path.join(DATA_ROOT, 'valid', 'labels'), old_class_id=2, new_class_id=1)

# 更新data.yaml配置文件以反映类别变更
print("\n正在更新data.yaml配置文件以匹配新的类别信息...")
with open(CONFIG_FILE_PATH, 'r', encoding='utf-8') as f:
    config_update_data = yaml.safe_load(f)

# 更新总类别数(nc)和类别名称(names)
config_update_data['nc'] = 2
config_update_data['names'] = ['head', 'helmet'] # 假设类别ID 0为'head', 类别ID 1为'helmet'

with open(CONFIG_FILE_PATH, 'w', encoding='utf-8') as f:
    yaml.dump(config_update_data, f, default_flow_style=False, allow_unicode=True)

print("data.yaml已更新为:")
print(yaml.dump(config_update_data, default_flow_style=False, allow_unicode=True))

# 最终统计标签分布以验证清洗和重映射效果
final_train_label_counts = count_yolo_labels(os.path.join(DATA_ROOT, 'train', 'labels'))
final_val_label_counts = count_yolo_labels(os.path.join(DATA_ROOT, 'valid', 'labels'))
total_final_label_counts = final_train_label_counts + final_val_label_counts
print("\n最终清理和重映射后的各类别标签分布:")
for cls_id, count_val in sorted(total_final_label_counts.items()):
    class_name = config_update_data['names'][cls_id] if cls_id < len(config_update_data['names']) else f"未知类别_{cls_id}"
    print(f"类别 '{class_name}' (ID: {cls_id}) 共有 {count_val} 个实例。")
展示部分数据集图片
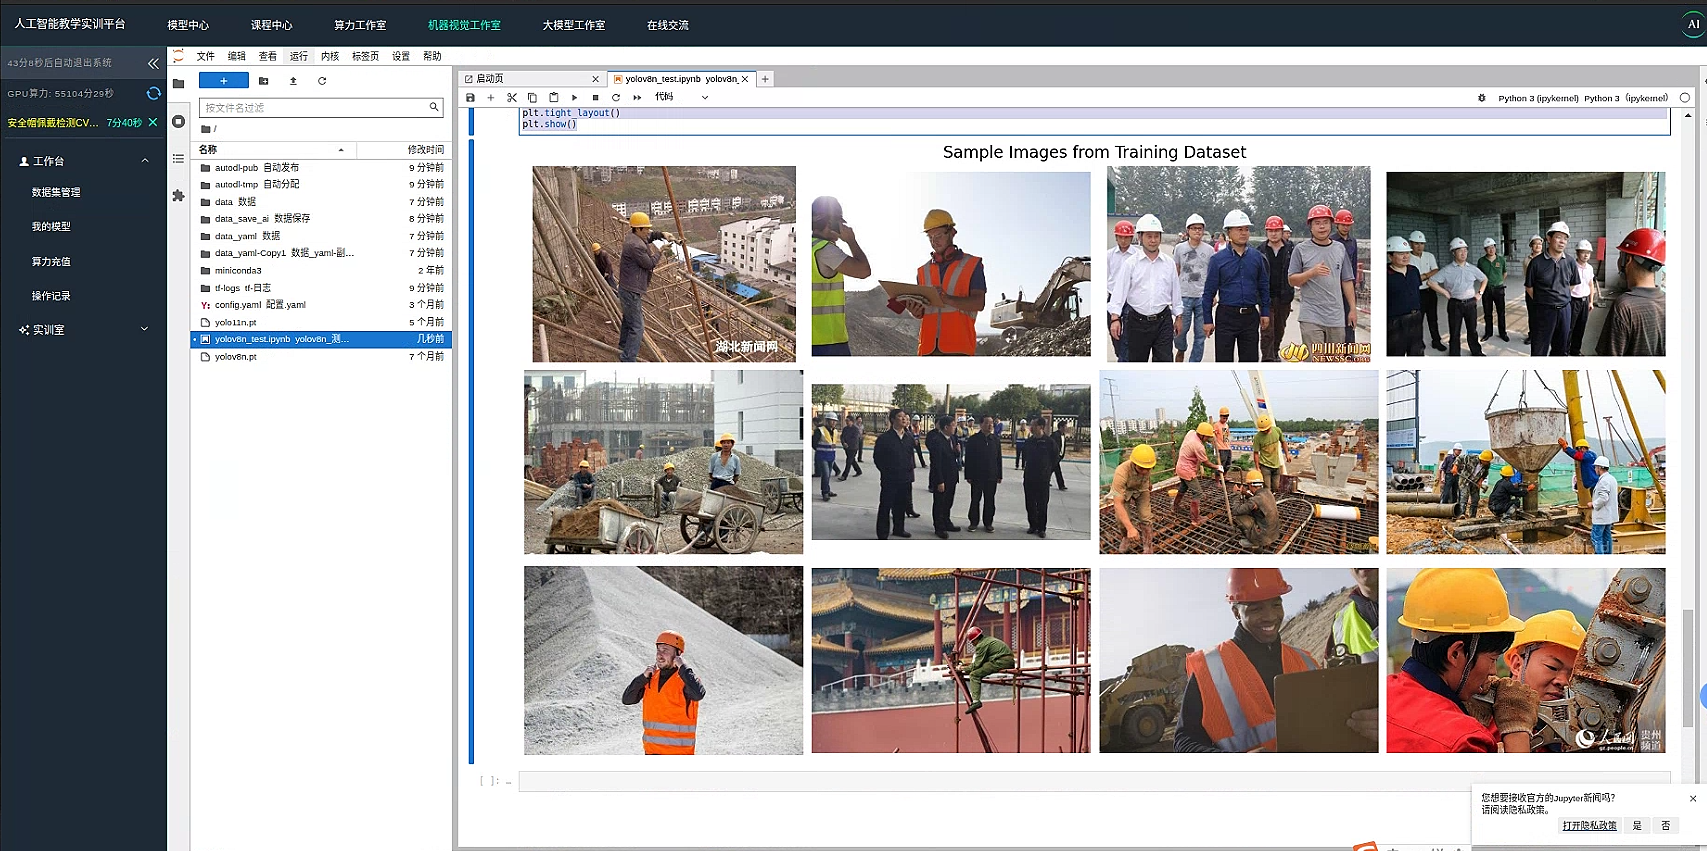
为了直观检查数据集内容,我们随机选取并展示一部分训练集图片。这有助于确保图片能够正确加载,并对数据质量有一个初步的印象。
import matplotlib.pyplot as plt
from PIL import Image
import random

# 选择用于图片展示的目录 (例如,训练集图片)
display_images_from_dir = os.path.join(DATA_ROOT, 'train', 'images')
all_image_filenames = [f for f in os.listdir(display_images_from_dir) if f.lower().endswith(('.jpg', '.jpeg', '.png'))]

if not all_image_filenames:
    print(f"在 {display_images_from_dir} 目录中未找到任何图片用于展示。")
else:
    # 随机选择最多12张图片进行展示
    num_to_display_samples = min(len(all_image_filenames), 12)
    selected_image_samples = random.sample(all_image_filenames, num_to_display_samples)

    fig, axes = plt.subplots(3, 4, figsize=(20, 15)) # 调整图片大小以获得更好的显示效果
    axes = axes.ravel() # 将二维数组的axes扁平化,方便迭代

    for i, img_file in enumerate(selected_image_samples):
        img_full_path = os.path.join(display_images_from_dir, img_file)
        try:
            image_data = Image.open(img_full_path)
            axes[i].imshow(image_data)
            axes[i].set_title(img_file, fontsize=10)
            axes[i].axis('off')
        except Exception as e:
            axes[i].set_title(f"加载失败: {img_file}", fontsize=10)
            axes[i].axis('off')
            print(f"加载图片 {img_file} 失败: {e}")

    # 隐藏未使用的子图
    for j in range(num_to_display_samples, len(axes)):
        fig.delaxes(axes[j])

    plt.suptitle('训练数据集示例图片', fontsize=22)
    plt.tight_layout(rect=[0, 0.03, 1, 0.95]) # 调整布局,防止标题重叠
    plt.show()
下图展示了从训练集中随机抽取的图片样本:
模型配置与训练
YOLOv11模型架构定义
本项目采用定制化的YOLOv11s模型。以下是其配置文件内容,其中num_classes已调整为2,以匹配我们清洗后的"head"和"helmet"两个类别。
# ultralytics_yolo11s_custom.yaml
# 基于Ultralytics YOLO11s模型,针对安全帽检测任务进行定制

# 模型复合缩放常量,例如 'model=yolo11n.yaml' 会调用 yolo11.yaml 并使用 'n' 级别缩放
scales:
    s: [0.50, 0.50, 1024] # 摘要: 319层, 9458752参数, 9458736梯度, 21.7 GFLOPs

# YOLO11s 骨干网络
backbone:
    # [来自, 重复次数, 模块, 参数]
    - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
    - [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
    - [-1, 2, C3k2, [256, False, 0.25]]
    - [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
    - [-1, 2, C3k2, [512, False, 0.25]]
    - [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
    - [-1, 2, C3k2, [512, True]]
    - [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
    - [-1, 2, C3k2, [1024, True]]
    - [-1, 1, SPPF, [1024, 5]] # 9
    - [-1, 2, C2PSA, [1024]] # 10

# YOLO11s 检测头
head:
    - type: DynamicHead # 替换检测头
      num_classes: 2 # 必须与data.yaml中的nc一致,这里设为2 (head, helmet)
      in_channels: [256, 256, 256]
      anchors: 3 # 每个尺度预测3个anchor
      loss_cls:
        - type: FocalLoss
          alpha: [0.25, 0.75] # 反向补偿head类别的低样本量
      loss_box: CIoU
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
    - [[-1, 6], 1, Concat, [1]] # cat backbone P4
    - [-1, 2, C3k2, [512, False]] # 13

    - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
    - [[-1, 4], 1, Concat, [1]] # cat backbone P3
    - [-1, 2, C3k2, [256, False]] # 16 (P3/8-small)

    - [-1, 1, Conv, [256, 3, 2]]
    - [[-1, 13], 1, Concat, [1]] # cat head P4
    - [-1, 2, C3k2, [512, False]] # 19 (P4/16-medium)

    - [-1, 1, Conv, [512, 3, 2]]
    - [[-1, 10], 1, Concat, [1]] # cat head P5
    - [-1, 2, C3k2, [1024, True]] # 22 (P5/32-large)

    - [[16, 19, 22], 1, Detect, [nc]] # Detect(P3, P4, P5)

neck:
    - type: BiFPN # 修改特征金字塔
      in_channels: [256, 512, 1024]
      out_channels: 256
      num_outs: 3
将上述内容保存为yolo11s_custom.yaml文件。然后,使用Ultralytics库加载此模型:
# 加载定制化的YOLOv11模型配置
custom_model_config_file = 'yolo11s_custom.yaml' # 确保此文件已存在
yolo_detection_model = YOLO(custom_model_config_file)

print("\n加载模型架构信息:")
print(yolo_detection_model.info())
训练参数配置与模型训练
为了获得最佳的检测性能,需要精心配置训练参数。这里我们设置了训练轮数、批次大小、图片尺寸、优化器、学习率等。同时,为了增强模型的泛化能力和鲁棒性,特别是针对工地复杂多变的环境,我们还调整了多种数据增强策略,如HSV颜色空间扰动、翻转、马赛克、MixUp和Copy-Paste等。
# 启动模型训练过程
training_results = yolo_detection_model.train(
    data=CONFIG_FILE_PATH,       # 数据集配置文件路径
    epochs=100,                  # 训练的总轮数
    batch=40,                    # 每个批次的图片数量
    imgsz=800,                   # 输入图片大小 (正方形,有助于保持检测精度)
    device=0,                    # 指定使用第一个GPU进行训练 (0表示GPU, 或'cpu'使用CPU)
    patience=15,                 # 早停机制:如果在15个epoch内验证集损失没有改善,则停止训练
    optimizer='AdamW',           # 选用AdamW优化器
    lr0=0.001,                   # 初始学习率
    dropout=0.1,                 # 在训练期间应用的Dropout比率,有助于防止过拟合
    seed=42,                     # 随机种子,确保训练结果的可复现性
    # 数据增强参数调整,以适应工地复杂环境和提高模型鲁棒性
    hsv_h=0.015,                 # 色相(Hue)变化幅度(降低以减少对反光材质的敏感度)
    hsv_s=0.7,                   # 饱和度(Saturation)变化幅度(增强以应对工地灰尘环境)
    hsv_v=0.4,                   # 明度(Value)变化幅度(增强以应对不同光照条件)
    fliplr=0.5,                  # 随机水平翻转概率,增加数据多样性
    mosaic=1.0,                  # 必须开启Mosaic数据增强(融合四张图片,有效提升小目标检测)
    mixup=0.2,                   # 启用MixUp数据增强(混合两张图片及其标签)
    copy_paste=0.3,              # 启用Copy-Paste数据增强(有助于改善小目标密集场景的检测)
    erasing=0.4,                 # 随机擦除概率,模拟部分遮挡情况
    degrees=15,                  # 图像随机旋转的最大角度
    cache='ram',                 # 缓存图片到内存以加速训练过程
    pretrained=True              # 使用预训练权重进行初始化,加速收敛
)
训练完成后,模型会输出详细的性能指标。下图展示了训练过程中的关键指标,如精确率、召回率和mAP等。
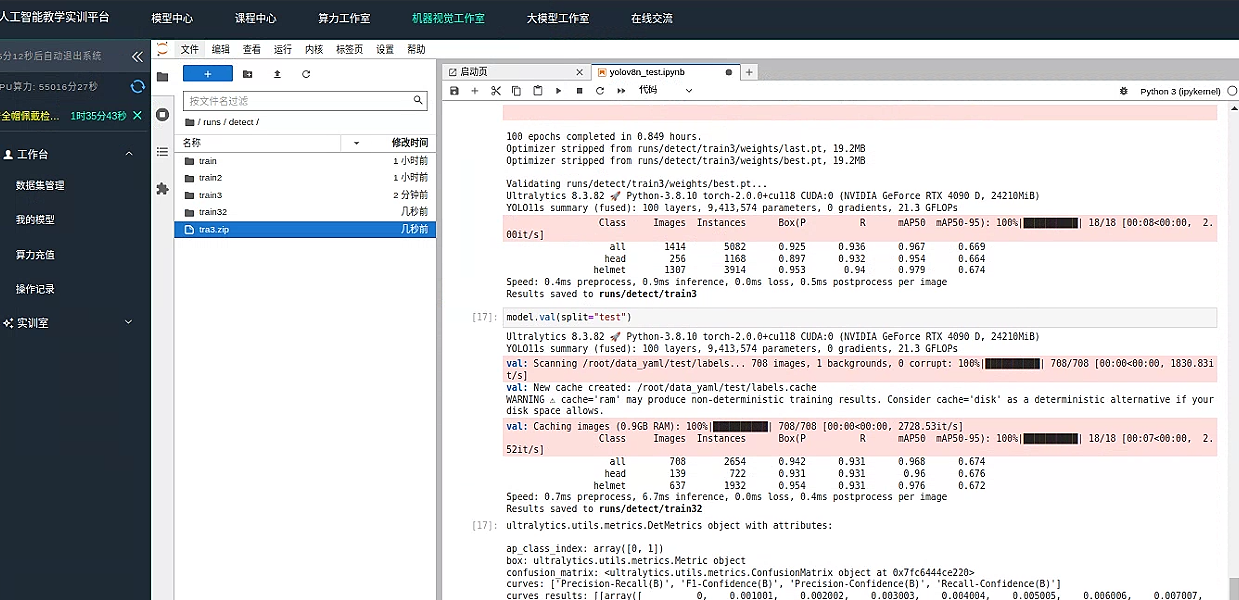
从训练结果来看,模型表现良好。整体(all 类别)的精度达到0.942,召回率为0.931,说明绝大部分目标都被准确检测到。"head"和"helmet"两个类别的表现也均达到90%以上的精度和召回率。mAP50达到0.968,表明在宽松的IoU阈值下,模型检测效果极佳;mAP50-95为0.674,说明在更严格的条件下仍有提升空间。此外,每张图片的推理时间约为6.7ms,展示了模型的高效运行能力。
