大语言模型智能体架构演进:从ReAct推理到多智能体协同调度
智能体工程化的四层架构范式
在当前的智能体(Agent)工程实践中,将系统架构解耦为四个核心层级已成为主流标准。这种分层设计本质上是对智能体"感知、推理、行动、协作"四大核心能力的工程化映射。
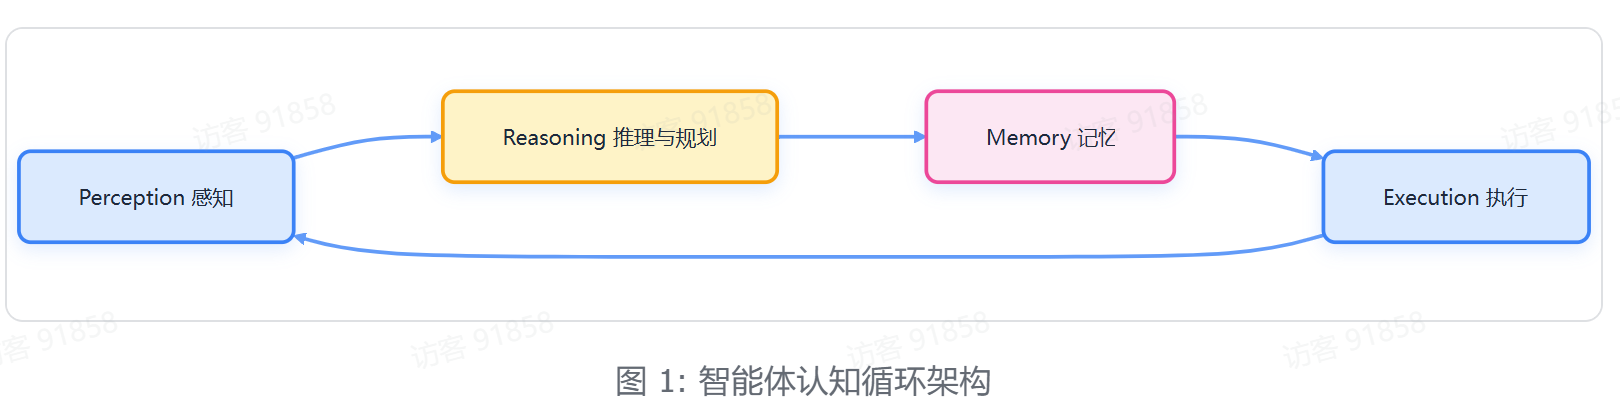
通过这种分层,复杂的 Agentic Workflow 被有效拆解:
- 指令层(Prompt):负责结构化输入输出与模板生成,塑造模型的行为边界(Behavior Shaping),决定模型"如何思考"。
- 上下文层(Context):管理动态上下文窗口与 RAG(检索增强生成),注入外部知识(Knowledge Injection),决定模型"知道什么"。
- 工具层(Tool):基于 MCP 等协议接入外部 API,赋予模型执行能力(Action Execution),决定模型"能做什么"。
- 编排层(Agent):统筹规划、记忆管理及多智能体协同(Orchestration & Planning),决定"整体如何运作"。
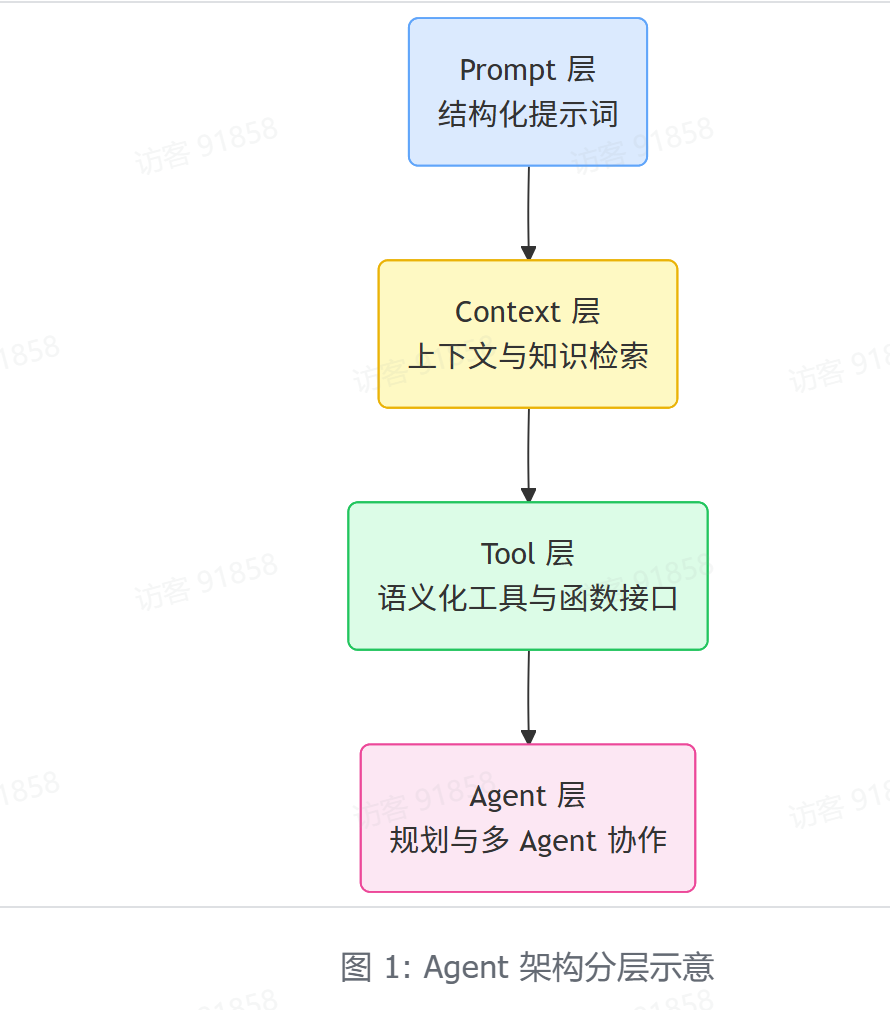
相较于早期的单层 ReAct 或简单的链式调用,四层架构在处理多轮对话、长周期任务以及 RAG 与工具混合调用的场景中表现出极高的工程鲁棒性。
ReAct 范式的核心机制
ReAct 的核心思想可以概括为:显式推理(Reasoning)与工具调用(Acting)的交替循环。其基本执行流为:思考(Thought) → 行动(Action) → 观察(Observation)。
以下是重构后的 ReAct 核心循环代码,采用更面向对象的封装方式:
class CognitiveAgent:
    def __init__(self, llm_client, tool_registry, max_iterations=10):
        self.llm = llm_client
        self.tools = tool_registry
        self.max_iterations = max_iterations

    def execute(self, objective: str) -> str:
        memory_trace = []
        current_feedback = ""

        for _ in range(self.max_iterations):
            # 1. 推理阶段 (Reasoning)
            reasoning_step = self.llm.generate_reasoning(
                goal=objective,
                history=memory_trace,
                latest_feedback=current_feedback
            )

            # 2. 决策阶段 (Action)
            decision = self.llm.determine_action(
                reasoning=reasoning_step,
                available_tools=self.tools.get_schemas()
            )

            # 3. 终止条件判断
            if decision.is_terminal():
                return decision.final_payload

            # 4. 执行与观察阶段 (Observation)
            current_feedback = self.tools.invoke(
                tool_name=decision.target_tool,
                parameters=decision.tool_params
            )

            # 5. 状态更新
            memory_trace.append({
                "reasoning": reasoning_step,
                "decision": decision.to_dict(),
                "feedback": current_feedback
            })

        return "Error: Maximum iteration limit reached without final answer."
该循环的本质在于:模型首先基于当前状态生成下一步计划,随后决定调用特定工具,系统执行工具并将环境反馈返回给模型,模型再基于新反馈进行下一轮推理,直至任务完成。
思维链(CoT)与 ReAct 的本质差异
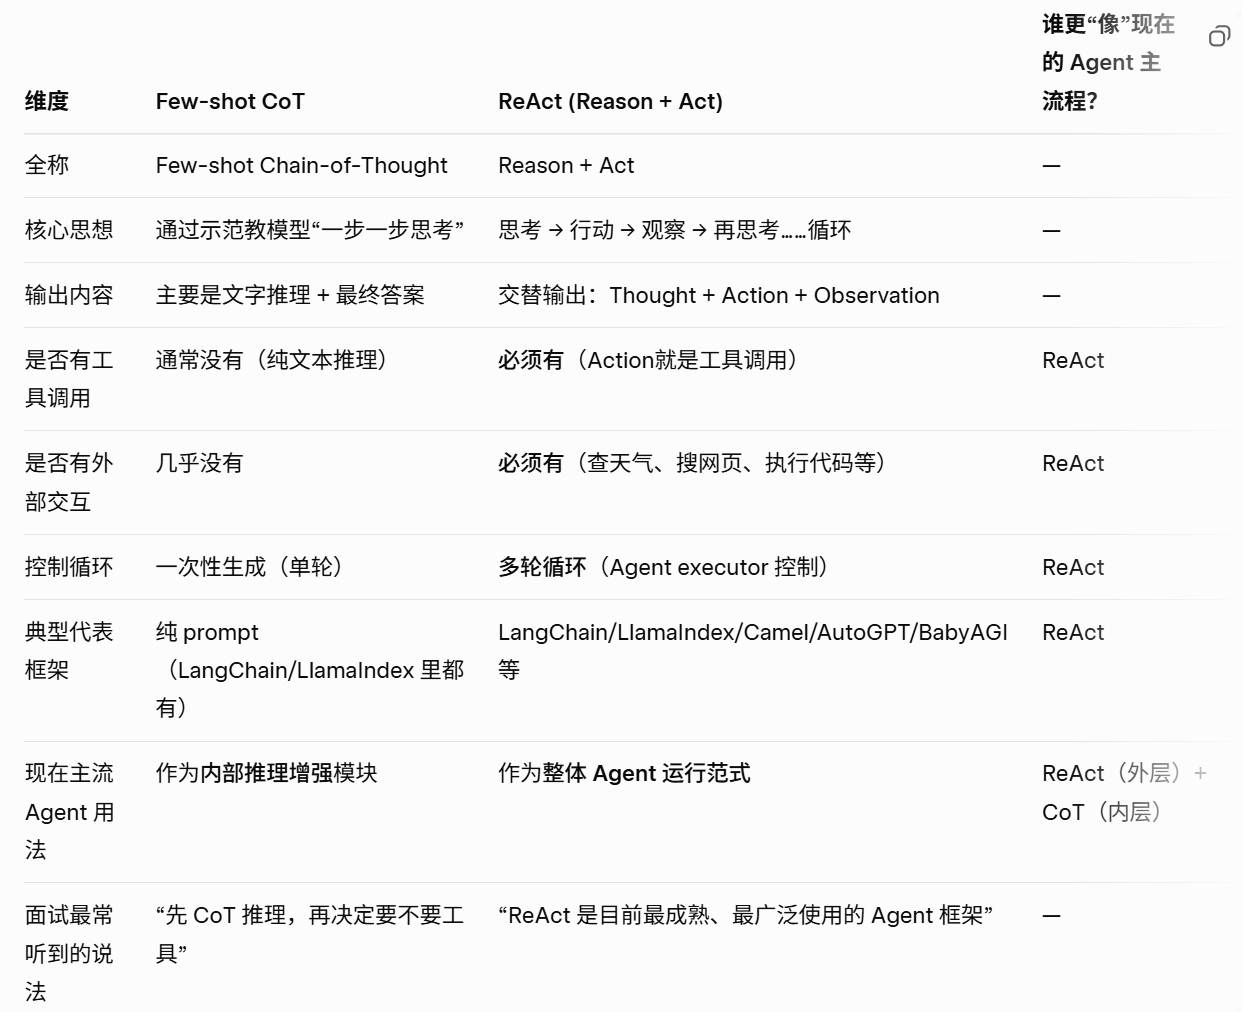
在探讨智能体推理时,常将 Few-shot CoT 与 ReAct 进行对比。两者的核心分歧在于是否具备环境交互能力:
- CoT(思维链):纯粹的"内部思考"。通过 Few-shot 提示让模型学习输出中间推理步骤(Step-by-step),但不与外部环境发生实质性交互。
- ReAct:"思考"与"行动"的结合。模型不仅在内部推理,还能通过工具调用获取外部真实世界的反馈,并据此修正后续推理。
多智能体协同调度模式
当单一 Agent 无法胜任复杂任务时,多智能体(Multi-Agent)架构成为必然选择。其协作模式主要分为两类:
- 水平协同(并行专家模式):多个 Agent 同时处理同类或同层级任务,最终通过投票、融合等机制输出结果。适用于高吞吐需求、RAG 多路召回等场景。
- 垂直协同(流水线分工模式):多个 Agent 按阶段串行处理任务,上游输出作为下游输入。适用于长链路推理和复杂的 Agentic Workflow。
在真实的工程落地中,系统通常采用混合架构:先进行垂直拆解,再进行水平扩展,最后垂直收敛。
           [Planner / 任务拆解]
                  │
      ┌───────────┼───────────┐
      ▼           ▼           ▼
 [Worker A]  [Worker B]  [Worker C]  <- (水平并行执行)
      │           │           │
      └───────────┼───────────┘
                  ▼
         [Critic / 结果收敛]
在这种混合架构中,每个节点本质上仍是一个 ReAct 循环,只是其角色定位(规划、执行、评估)有所不同。
多智能体调度代码实现
以下使用 Python 的 asyncio 异步框架重构了多智能体调度器,以更好地支持高并发的水平扩展场景:
import asyncio
import json

class BaseAgent:
    def __init__(self, llm, role="worker"):
        self.llm = llm
        self.role = role

    async def call_llm(self, prompt: str) -> str:
        # 模拟异步 LLM 调用
        return await self.llm.async_generate(prompt)

class TaskDecomposer(BaseAgent):
    async def decompose(self, objective: str) -> list[str]:
        prompt = f"""作为任务规划师,请将以下复杂目标拆解为独立的子任务列表。
目标:{objective}
请仅返回 JSON 格式的字符串数组。"""
        response = await self.call_llm(prompt)
        return json.loads(response)

class ParallelExecutor:
    def __init__(self, llm, tools):
        self.llm = llm
        self.tools = tools

    async def _run_single_worker(self, subtask: str) -> str:
        worker = CognitiveAgent(self.llm, self.tools)
        # 复用 ReAct 核心逻辑,将同步执行放入线程池以适配异步事件循环
        loop = asyncio.get_running_loop()
        return await loop.run_in_executor(None, worker.execute, subtask)

    async def execute(self, subtasks: list[str]) -> list[str]:
        # 使用 asyncio.gather 实现真正的异步并发
        tasks = [self._run_single_worker(task) for task in subtasks]
        return await asyncio.gather(*tasks)

class ResultSynthesizer(BaseAgent):
    async def synthesize(self, objective: str, candidate_results: list[str]) -> str:
        prompt = f"""作为结果评估与融合专家,请基于以下候选结果,评估其正确性并融合出最终答案。
原始目标:{objective}
候选结果:{candidate_results}
请直接输出最终答案。"""
        return await self.call_llm(prompt)

class SwarmDirector:
    def __init__(self, llm, tools):
        self.llm = llm
        self.tools = tools

    async def run(self, objective: str) -> str:
        # 阶段 1:垂直拆解
        decomposer = TaskDecomposer(self.llm, role="planner")
        subtasks = await decomposer.decompose(objective)
        print(f"[Planner] 拆解子任务: {subtasks}")

        # 阶段 2:水平扩展
        executor = ParallelExecutor(self.llm, self.tools)
        parallel_results = await executor.execute(subtasks)
        print(f"[Workers] 并行执行结果: {parallel_results}")

        # 阶段 3:垂直收敛
        synthesizer = ResultSynthesizer(self.llm, role="critic")
        final_output = await synthesizer.synthesize(objective, parallel_results)

        return final_output

# 运行示例
if __name__ == "__main__":
    # 伪代码:初始化异步 LLM 客户端和工具注册表
    mock_llm = MockAsyncLLM()
    mock_tools = MockToolRegistry()

    director = SwarmDirector(mock_llm, mock_tools)
    final_result = asyncio.run(director.run("分析全球宏观经济趋势对新能源车企供应链的影响"))
    print(f"[Director] 最终输出: {final_result}")
该架构通过 TaskDecomposer 进行垂直拆解,利用 ParallelExecutor 结合异步并发实现水平扩展,每个 Worker 内部维持独立的 ReAct 循环,最终由 ResultSynthesizer 完成垂直收敛。这种设计显著提升了复杂任务的处理效率与系统的整体鲁棒性。
