深入理解人工神经网络架构与梯度下降优化算法
一、 人工神经网络的拓扑结构与数学抽象
人工神经网络(ANN)作为一种受生物神经系统启发的计算范式,通过构建多层互联的处理节点来逼近复杂的非线性映射关系。网络中的基本计算单元被称为"神经元",它们通过可学习的连接权重进行信息交互,从而实现对输入数据的高维特征提取与变换。
1.1 核心组件与工作机制
一个典型的多层前馈神经网络主要包含以下层级与组件:
- 输入层(Input Layer):负责接收外部特征数据,通常不进行复杂的数学变换,仅作为数据的传递入口。
- 隐藏层(Hidden Layers):网络的核心计算区域,包含一个或多个层级。通过权重矩阵乘法、偏置相加以及非线性激活函数,将输入空间映射到新的特征空间。
- 输出层(Output Layer):根据具体任务(如分类或回归)输出最终的预测结果。
单个神经元的计算逻辑可以通过以下数学模型描述:
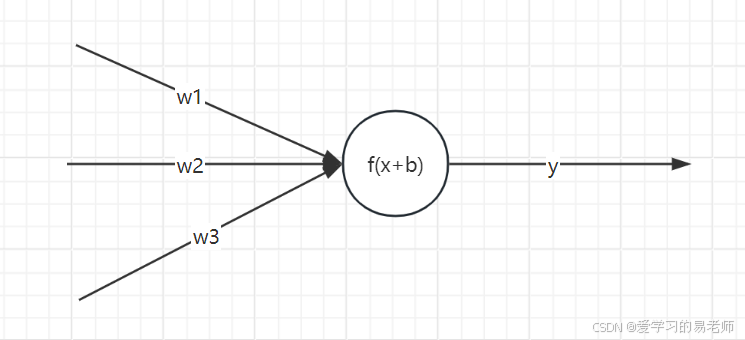
对于第 $i$ 个输入 $x_i$ 及其对应的权重 $w_i$,神经元的净输入 $z$ 与输出 $a$ 计算如下:
$$ z = \sum_{i=1}^{n} w_i x_i + b $$
$$ a = \sigma(z) $$
其中,$b$ 为偏置项,$\sigma$ 为激活函数。常见的激活函数包括 Sigmoid 函数 $\sigma(z) = \frac{1}{1 + e^{-z}}$ 和 ReLU 函数 $f(z) = \max(0, z)$。
1.2 前向传播的矩阵运算
在多层网络中,前向传播过程可以通过矩阵运算高效表示。假设第 $l$ 层的权重矩阵为 $W^{[l]}$,偏置向量为 $b^{[l]}$,则该层的线性组合 $z^{[l]}$ 与激活输出 $a^{[l]}$ 为:
$$ z^{[l]} = W^{[l]} a^{[l-1]} + b^{[l]} $$
$$ a^{[l]} = \sigma(z^{[l]}) $$
以下图所示的双层网络结构为例,输入层接收二维特征,隐藏层包含四个神经元,输出层为二维结果。
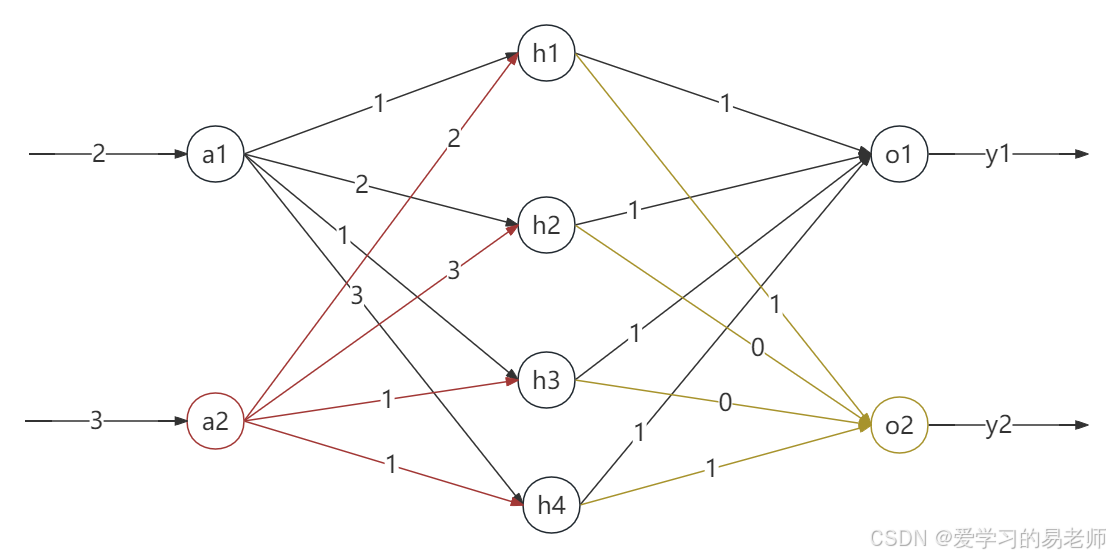
若输入向量 $\mathbf{x} = [2, 3]^T$,隐藏层权重矩阵 $\mathbf{W}_{\text{hidden}}$ 与偏置 $\mathbf{b}_{\text{hidden}}$ 定义如下:
$$ \mathbf{W}_{\text{hidden}} = \begin{bmatrix} 1 & 2 \\ 2 & 3 \\ 1 & 1 \\ 3 & 1 \end{bmatrix}, \quad \mathbf{b}_{\text{hidden}} = \begin{bmatrix} 0.2 \\ 0.2 \\ 0.2 \\ 0.2 \end{bmatrix} $$
通过矩阵乘法可得隐藏层的线性输出 $\mathbf{z}_{\text{hidden}} = \mathbf{W}_{\text{hidden}} \mathbf{x} + \mathbf{b}_{\text{hidden}} = [8.2, 13.2, 5.2, 9.2]^T$。随后应用 Sigmoid 激活函数,得到隐藏层的最终输出 $\mathbf{a}_{\text{hidden}} \approx [0.9997, 0.9999, 0.9933, 0.9998]^T$。该输出将作为下一层的输入继续向前传播。
二、 梯度下降法与参数优化机制
神经网络的学习过程本质上是求解一个高维非凸优化问题。梯度下降法(Gradient Descent)是解决此类问题的核心迭代算法,其目标是通过不断调整网络参数,使损失函数收敛至最小值。
2.1 梯度的数学本质
在微积分中,梯度是一个向量,表示多元函数在某一点处变化率最大的方向。对于损失函数 $L(\mathbf{w})$,其关于参数向量 $\mathbf{w}$ 的梯度定义为:
$$ \nabla_{\mathbf{w}} L = \left[ \frac{\partial L}{\partial w_1}, \frac{\partial L}{\partial w_2}, \dots, \frac{\partial L}{\partial w_n} \right]^T $$
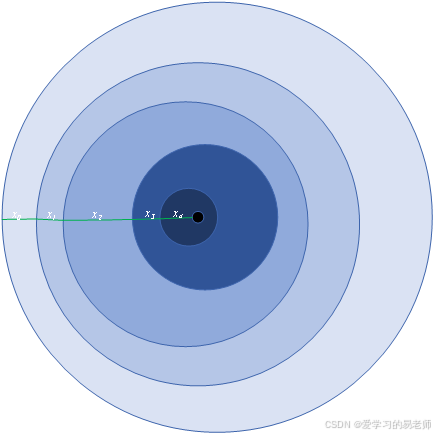
梯度的方向指向函数值增长最快的方向。因此,为了使损失函数最小化,参数的更新规则应沿着梯度的反方向进行:
$$ \mathbf{w}_{k+1} = \mathbf{w}_k - \alpha \nabla_{\mathbf{w}} L(\mathbf{w}_k) $$
其中,$\alpha$ 为学习率(步长),控制每次迭代的参数更新幅度。
2.2 神经网络中的反向传播
在神经网络中,损失函数 $L$ 是预测值 $\hat{y}$ 与真实标签 $y$ 之间差异的度量。以均方误差(MSE)为例:
$$ L(\hat{y}, y) = \frac{1}{2} (\hat{y} - y)^2 $$
为了计算深层参数的梯度,我们需要使用微积分中的链式法则,将误差从输出层逐层反向传播至隐藏层。假设网络采用线性激活函数 $f(x) = 2x$,且无偏置项,前向传播过程为:
$$ \mathbf{h} = 2(\mathbf{W}_{\text{hidden}} \mathbf{x}) $$
$$ \mathbf{y}_m = \mathbf{W}_{\text{output}} \mathbf{h} $$
反向传播的梯度计算步骤如下:
- 输出层误差:$\nabla_{\mathbf{y}_m} L = \mathbf{y}_m - \mathbf{y}_t$
- 输出层权重梯度:$\nabla_{\mathbf{W}_{\text{output}}} L = (\mathbf{y}_m - \mathbf{y}_t) \mathbf{h}^T$
- 隐藏层误差:$\nabla_{\mathbf{h}} L = \mathbf{W}_{\text{output}}^T (\mathbf{y}_m - \mathbf{y}_t) \cdot 2$ (乘以2为激活函数导数)
- 隐藏层权重梯度:$\nabla_{\mathbf{W}_{\text{hidden}}} L = \nabla_{\mathbf{h}} L \cdot \mathbf{x}^T$
三、 算法实现与框架应用
3.1 基于 NumPy 的底层实现
以下代码展示了如何脱离深度学习框架,使用 NumPy 手动实现上述数学推导中的前向传播与反向传播逻辑。
import numpy as np

class ManualNeuralNet:
    def __init__(self, learning_rate=0.01):
        self.lr = learning_rate
        # 初始化网络权重
        self.W_hidden = np.array([[1, 2], [2, 3], [1, 1], [3, 1]], dtype=float)
        self.W_output = np.array([[1, 1, 1, 1], [1, 0, 0, 1]], dtype=float)

    def forward(self, x):
        # 隐藏层:线性变换后乘以2 (模拟 f(x)=2x)
        self.x_input = x
        self.h_linear = np.dot(self.W_hidden, x)
        self.h_act = 2 * self.h_linear

        # 输出层
        self.y_pred = np.dot(self.W_output, self.h_act)
        return self.y_pred

    def backward(self, y_target):
        # 1. 计算输出层梯度
        grad_y = self.y_pred - y_target
        grad_W_out = np.outer(grad_y, self.h_act)

        # 2. 计算隐藏层梯度 (链式法则,乘以激活函数导数2)
        grad_h = np.dot(self.W_output.T, grad_y) * 2
        grad_W_hid = np.outer(grad_h, self.x_input)

        # 3. 更新权重
        self.W_output -= self.lr * grad_W_out
        self.W_hidden -= self.lr * grad_W_hid

        return grad_W_hid, grad_W_out

# 执行单次训练迭代
nn_model = ManualNeuralNet(learning_rate=0.01)
inputs = np.array([2, 3])
targets = np.array([2, 3])

predictions = nn_model.forward(inputs)
print(f"预测输出: {predictions}")

grads = nn_model.backward(targets)
print(f"隐藏层权重梯度:\n{grads[0]}")
print(f"更新后的输出层权重:\n{nn_model.W_output}")
3.2 基于 PaddlePaddle 的模型构建
在实际工程中,我们通常使用深度学习框架来自动处理复杂的反向传播计算。以下是使用 PaddlePaddle 构建相同拓扑结构网络的示例。
import paddle
import paddle.nn as nn
from paddle.optimizer import SGD

class CustomPerceptron(nn.Layer):
    def __init__(self):
        super(CustomPerceptron, self).__init__()
        # 定义无偏置的线性层
        self.fc1 = nn.Linear(2, 4, bias_attr=False)
        self.fc2 = nn.Linear(4, 2, bias_attr=False)

    def forward(self, x):
        # 保持与前文数学推导一致的自定义激活逻辑
        h = 2.0 * self.fc1(x)
        return self.fc2(h)

# 初始化模型并设定初始权重
model = CustomPerceptron()
model.fc1.weight.set_value(paddle.to_tensor([[1, 2], [2, 3], [1, 1], [3, 1]], dtype='float32'))
model.fc2.weight.set_value(paddle.to_tensor([[1, 1, 1, 1], [1, 0, 0, 1]], dtype='float32'))

# 构造模拟数据集
batch_size = 64
features = paddle.randn([batch_size, 2])
labels = paddle.sum(features, axis=1, keepdim=True)

# 配置优化器与损失函数
optimizer = SGD(learning_rate=0.01, parameters=model.parameters())
mse_loss = nn.MSELoss()

# 训练循环
epochs = 5
for epoch in range(epochs):
    outputs = model(features)
    loss = mse_loss(outputs, labels)

    loss.backward()
    optimizer.step()
    optimizer.clear_grad()

    print(f"Epoch [{epoch+1}/{epochs}], Loss: {loss.numpy()[0]:.4f}")
3.3 基于 PyTorch 的模型构建
PyTorch 提供了动态计算图机制,使得模型的前向传播与梯度计算更加直观。以下是等效的 PyTorch 实现方案。
import torch
import torch.nn as nn
import torch.optim as optim

class FeedForwardNet(nn.Module):
    def __init__(self):
        super(FeedForwardNet, self).__init__()
        self.layer_1 = nn.Linear(in_features=2, out_features=4, bias=False)
        self.layer_2 = nn.Linear(in_features=4, out_features=2, bias=False)

    def forward(self, x):
        # 应用线性激活变换
        hidden_rep = 2.0 * self.layer_1(x)
        return self.layer_2(hidden_rep)

# 实例化网络
net = FeedForwardNet()

# 注入初始权重参数
with torch.no_grad():
    net.layer_1.weight.copy_(torch.tensor([[1, 2], [2, 3], [1, 1], [3, 1]], dtype=torch.float32))
    net.layer_2.weight.copy_(torch.tensor([[1, 1, 1, 1], [1, 0, 0, 1]], dtype=torch.float32))

# 数据准备
num_samples = 128
X_data = torch.randn(num_samples, 2)
y_data = X_data.sum(dim=1, keepdim=True)

# 定义损失与优化器
criterion = nn.MSELoss()
sgd_optimizer = optim.SGD(net.parameters(), lr=0.01)

# 模型训练
num_epochs = 10
for epoch_idx in range(num_epochs):
    net.train()

    # 前向传播
    preds = net(X_data)
    current_loss = criterion(preds, y_data)

    # 反向传播与参数更新
    sgd_optimizer.zero_grad()
    current_loss.backward()
    sgd_optimizer.step()

    if (epoch_idx + 1) % 2 == 0:
        print(f"Training Epoch: {epoch_idx + 1}/{num_epochs} | MSE Loss: {current_loss.item():.4f}")

print("\nFinal Optimized Weights:")
print("Layer 1:", net.layer_1.weight.data)
print("Layer 2:", net.layer_2.weight.data)
