基于OpenXML SDK的Word表格数据提取与清洗实践
技术背景与架构选型
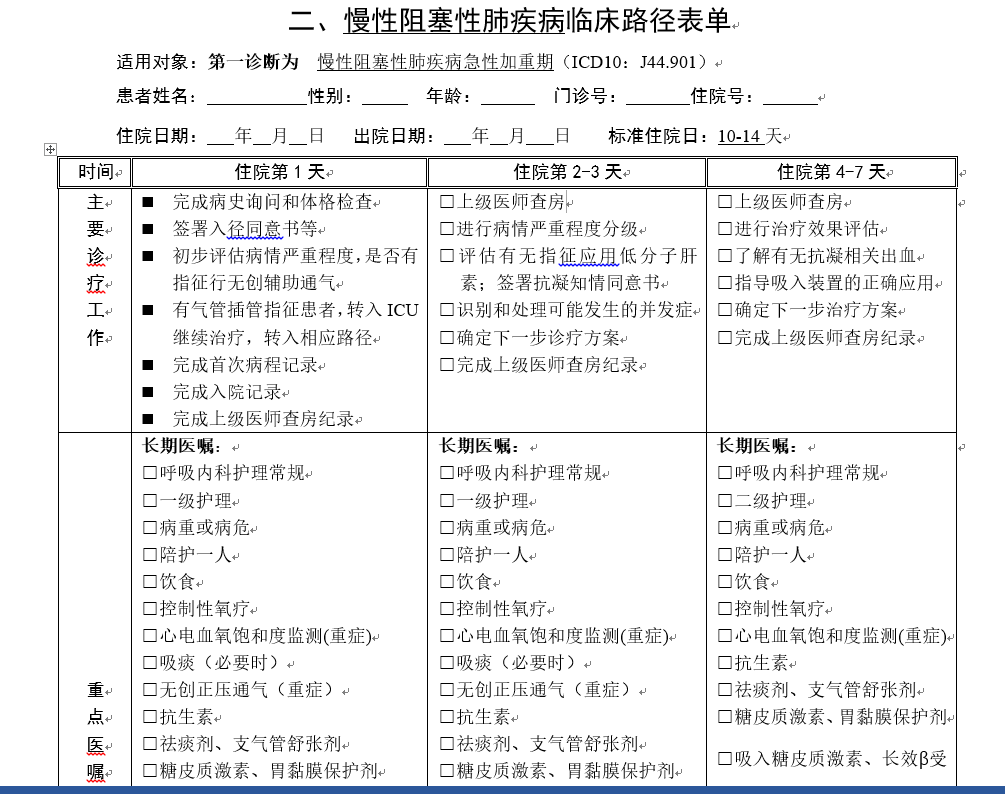
在企业级数据采集中,常需直接读取 Word 文档内的结构化信息(如表格行列及单元格文本),同时要求规避本地 Office 套件依赖以消除授权限制与后台进程残留问题。采用微软官方提供的 DocumentFormat.OpenXml.dll 配合 WindowsBase.dll 是一种高效的轻量级方案。该方案通过直接解析 .docx 底层的 XML 规范实现内容抽取,支持高度自定义的解析规则。需注意,该机制仅兼容 Office Open XML 标准格式,无法直接读取旧版 .doc 文件。此外,WPS、LibreOffice 等第三方办公软件生成的 XML 节点结构可能存在细微差异,实际工程中需通过容错逻辑进行兼容适配。
核心解析流程与实现
数据提取的核心在于定位文档主体(Body),逐级向下遍历表格(Table)、行(TableRow)与单元格(TableCell)节点。由于 OpenXML 对象模型未为单元格集合提供基于索引的访问器,通常需依赖迭代器配合原始 XML 字符串匹配来定位关键数据。
using System;
using System.Collections.Generic;
using System.IO;
using System.Linq;
using System.Text.RegularExpressions;
using DocumentFormat.OpenXml.Packaging;
using DocumentFormat.OpenXml.Wordprocessing;

public class DocxTableParser
{
    public static IEnumerable<List<string>> ExtractTableContent(Stream docStream)
    {
        using var wordPackage = WordprocessingDocument.Open(docStream, false);
        var documentBody = wordPackage.MainDocumentPart.Document.Body;

        // 获取文档内所有表格节点
        var tableNodes = documentBody.Descendants<Table>();

        foreach (var currentTable in tableNodes)
        {
            var extractedRows = new List<string>();
            foreach (var rowElement in currentTable.Descendants<TableRow>())
            {
                var cellValues = new List<string>();
                foreach (var cellElement in rowElement.Descendants<TableCell>())
                {
                    var rawCellMarkup = cellElement.InnerXml;
                    // 检测是否包含列表或段落样式标记
                    bool hasFormatTags = rawCellMarkup.Contains("<w:numPr>") || rawCellMarkup.Contains("<w:pPr>");

                    string cellText;
                    if (hasFormatTags)
                    {
                        cellText = TextSanitizer.RemoveXmlFormatting(rawCellMarkup);
                    }
                    else
                    {
                        cellText = rowElement.InnerText.Trim();
                    }

                    if (!string.IsNullOrWhiteSpace(cellText))
                    {
                        cellValues.Add(cellText);
                    }
                }
                extractedRows.AddRange(cellValues);
            }
            yield return extractedRows;
        }
    }
}
XML 标记剥离与文本清洗
提取的原始内容通常混杂大量样式定义、空白控制符及排版标签。通过编译型正则表达式可高效过滤无效节点,并处理常见的 HTML/XML 实体转义及特殊排版字符(如复选框符号 □)。
public static class TextSanitizer
{
    private static readonly Regex TagPattern = new Regex(@"<[^>]+>", RegexOptions.Compiled | RegexOptions.IgnoreCase);
    private static readonly Regex EntityPattern = new Regex(@"&\w+;|&#\d+;", RegexOptions.Compiled | RegexOptions.IgnoreCase);

    public static string RemoveXmlFormatting(string rawInput)
    {
        if (string.IsNullOrEmpty(rawInput)) return string.Empty;

        var cleaned = TagPattern.Replace(rawInput, string.Empty);
        cleaned = EntityPattern.Replace(cleaned, string.Empty);

        // 标准化空白字符与换行
        cleaned = Regex.Replace(cleaned, @"\s+", " ");

        // 移除特定厂商生成的排版占位符 (例如 U+25A1 方块符号)
        cleaned = cleaned.Replace("\u25A1", string.Empty);

        return cleaned.Trim();
    }
}
前端富文本粘贴预处理策略
当业务场景涉及用户将 Word 内容直接粘贴至网页编辑器并捕获 innerHTML 时,建议在前端执行初步格式化。通过统一换行标识、剔除冗余样式块及折叠连续空行,可显著降低后端二次解析的复杂度。
function preprocessPastedContent(rawHtml) {
  let processed = rawHtml;
  const newlineToken = "@rn";

  // 将常见换行元素替换为统一标识
  processed = processed.replace(/<br\s*\/?>|<\/p>/gi, newlineToken);
  processed = processed.replace(/<span[^>]*style="[^"]*white-space:pre[^"]*"[^>]*>/gi, newlineToken);

  // 批量移除 HTML/XML 标签结构
  processed = processed.replace(/<[^>]+>/g, '');

  // 清理特殊占位符与非常规空白
  const charFilterPattern = /\u25A1|\u00A0|\t/g;
  processed = processed.replace(charFilterPattern, '');

  // 合并连续换行符
  const multiLinePattern = new RegExp(`(${newlineToken})\\s*\\1+`, 'g');
  processed = processed.replace(multiLinePattern, newlineToken);

  return processed.trim();
}